推荐系统学习笔记
小红书的推荐系统
曝光→点击,停留几秒(说明不是误点)→阅读→点赞收藏转发评论
转化流程
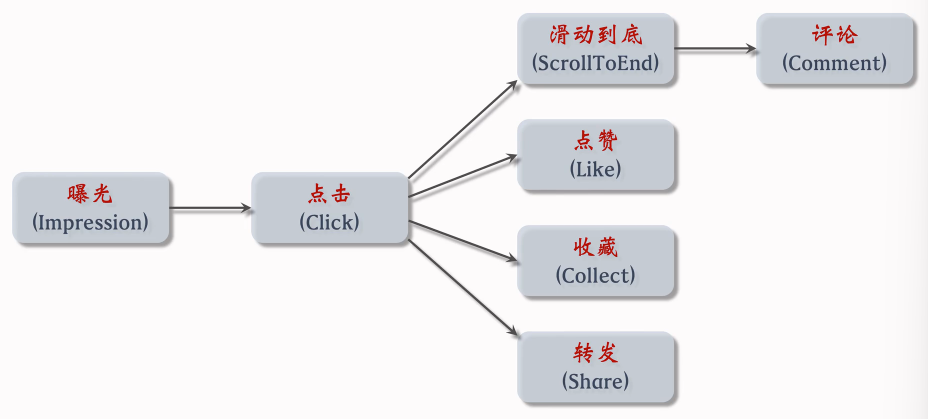
(抖音没有下滑和点击)
(短期)消费指标
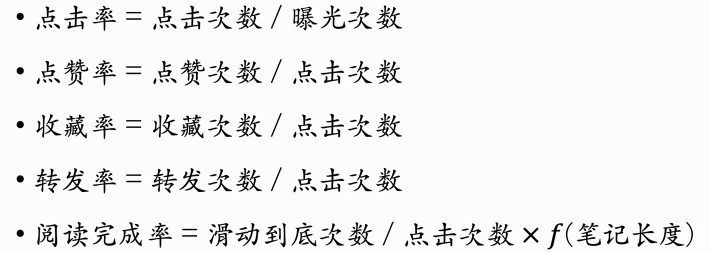
(不是衡量推荐系统好坏的根本指标)
北极星指标
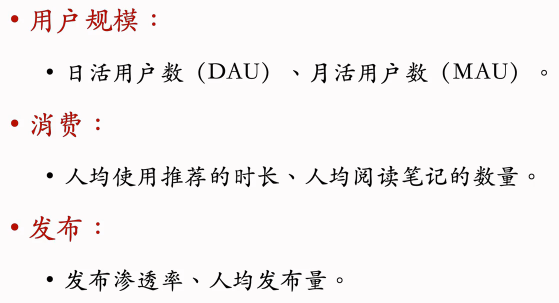
(最关键的指标,衡量好坏的根本标准)
通常来讲,点击率、点赞率与使用时长和阅读数量的涨跌是一致的,万一有冲突,以北极星指标为准。
希望推荐系统能激励作者发布,让我们的内容池变大,优质内容池是核心竞争力;激励发布通常是由冷启动负责(后面再讲冷启动)
实验流程
算法工程师的工作:对模型、特征、策略、系统做改进
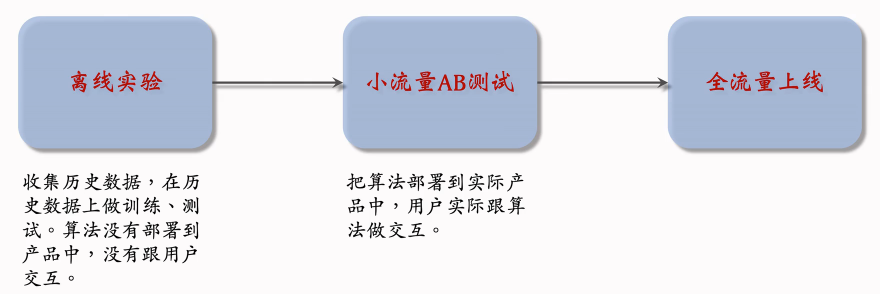
离线实验的结果有参考价值,能大致反映出算法的好坏;但是离线实验并没有线上实验可靠,想最终判断算法的好坏还是需要做线上实验。
北极星指标都是线上指标,只能通过线上实验获得,做离线实验无法得到。
具体做法是开小流量AB测试,把用户随机分为实验组和对照组,实验组用新策略,对照组用就策略;对比两者的业务指标,判断新策略是否会显著由于旧策略;如果新策略显著优于旧策略,可以加大流量,最终推全
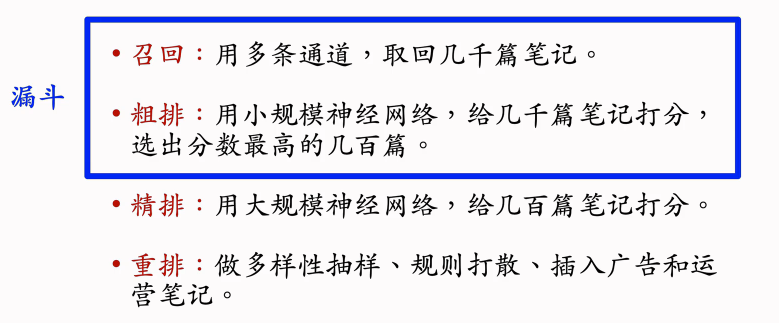
推荐系统链路
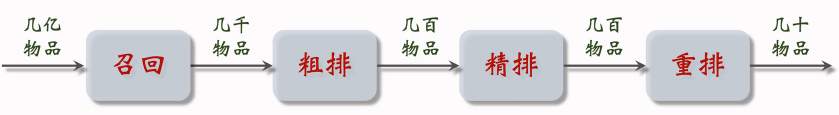
例如,小红书有上亿篇笔记,当刷新小红书的时候,系统会调用几十条召回通道,每条召回通道会取回几十到几百篇笔记,一共取回几千篇笔记。
做完召回之后,要从几千篇笔记中选出最感兴趣的。
粗排:用规模比较小的机器学习,给几千篇笔记逐一打分;按照分数做排序和截断,保留分数最高的几百篇笔记
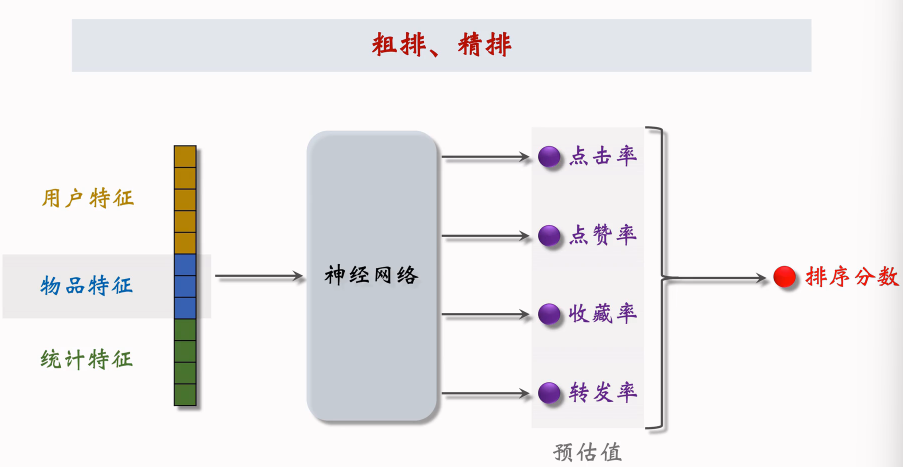
精排:要用到大规模的深度神经网络,给几百篇笔记逐一打分;精排的分数反映出用户对笔记的兴趣。在精排之后,可以做截断,也可以不做截断(小红书的精排不做截断,所有几百篇笔记都带着分数进入重排)。
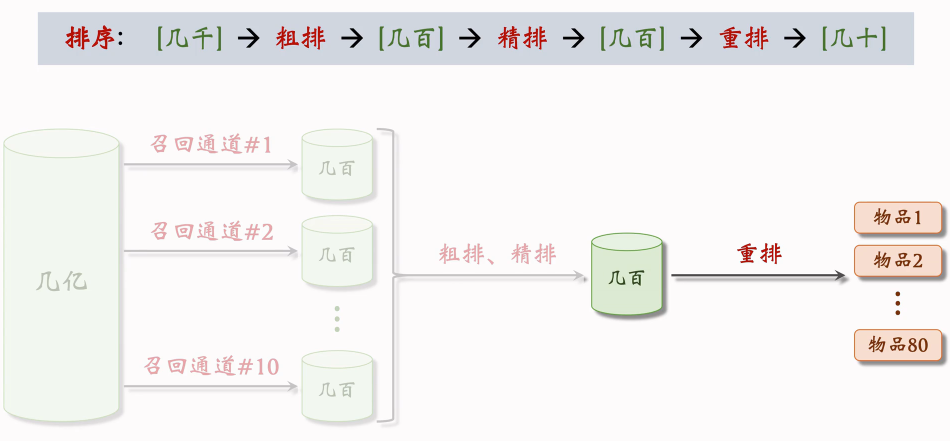
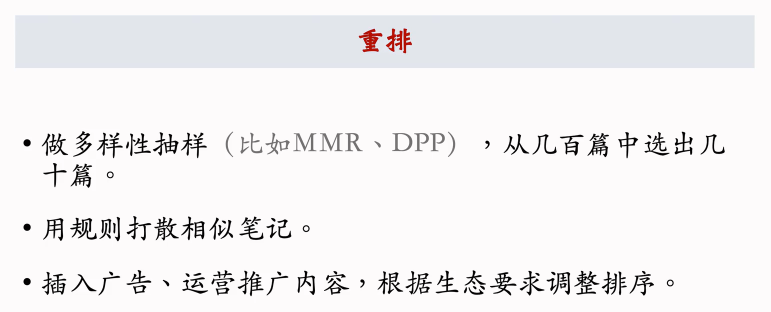
重排:会根据精排分数和多样性分数做随机抽样,得到几十篇笔记,然后把相似内容打散并且插入广告和运营内容。
推荐系统的目标:从物品的数据库中选出几十个物品展示给用户。
在小红书的场景下,物品就是笔记。一共有几亿篇笔记。
召回
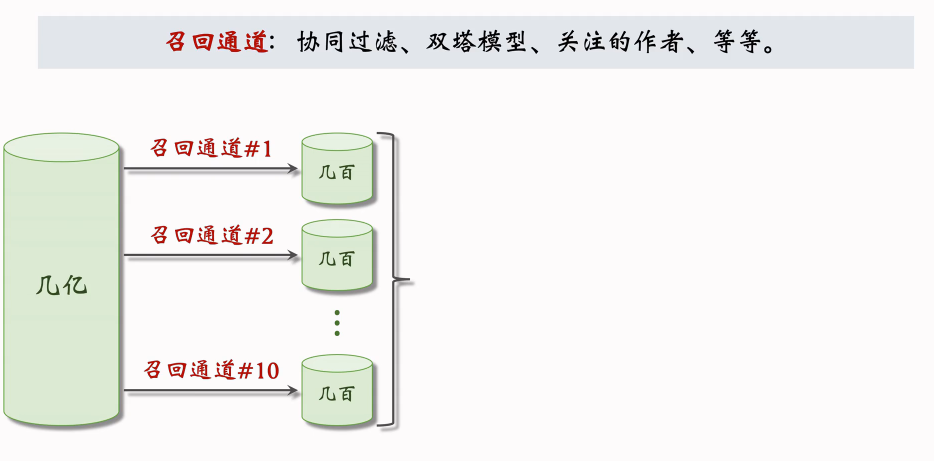
返回几千篇笔记,然后推荐系统会融合这些笔记,做去重和过滤。
过滤:排除掉作者不喜欢的笔记,不喜欢的话题
排序
用机器学习模型,预估用户对笔记的兴趣,保留分数最高的笔记
如果直接用大规模的神经网络,逐一对几千篇笔记打分,花费的代价会很大。为了解决计算量的问题,通常把排序分为粗排和精排两步。
粗排用比较简单的模型,快速给几千篇笔记打分,保留分数最高的几百篇笔记。
精排用较大的神经网络对几百篇笔记打分,不用做截断。
精排模型比粗排模型大很多,用的特征也更多。所以精排模型打分分数更可靠,但是精排的计算量很大——这就是为什么要先用粗排做筛选,然后用精排,这样做可以比较好的平衡计算量和准确性。
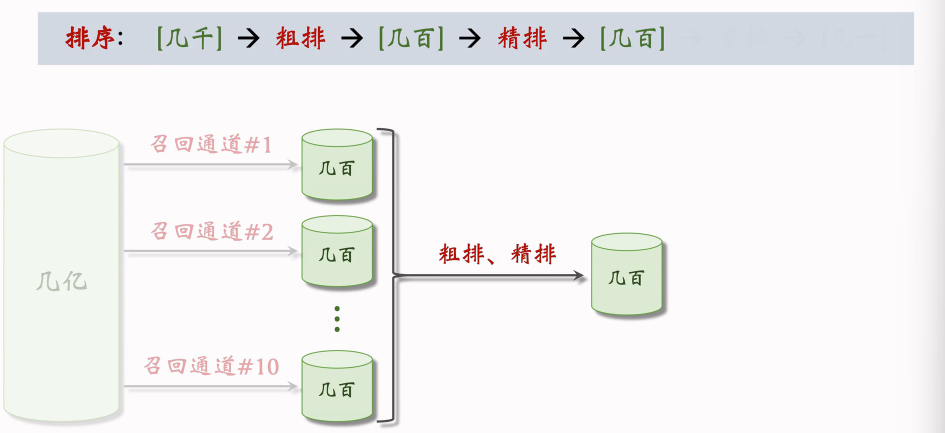
做完粗排和精排会得到几百篇笔记,每篇笔记会有一个分数,反映了用户对这些笔记的兴趣有多高。
重排
可以直接把笔记按照模型打的分数做排序,然后展示给用户,但此时的结果还存在不足,需要做一些调整,这一步叫做重排。
重排主要是考虑多样性,根据多样性做随机抽样,从几百篇笔记中选出几十篇,然后用规则将相似的笔记打散。
重排的结果就是最终展示给用户的物品。
总结
A/B测试
A/B测试基本思想
A/B测试
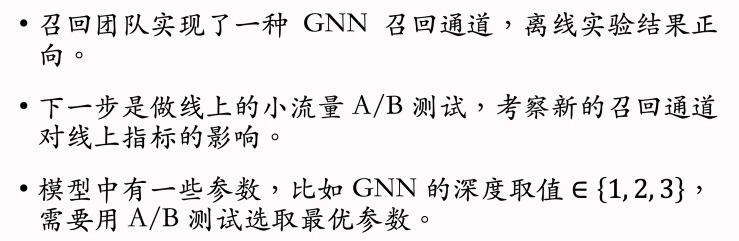
随机分桶
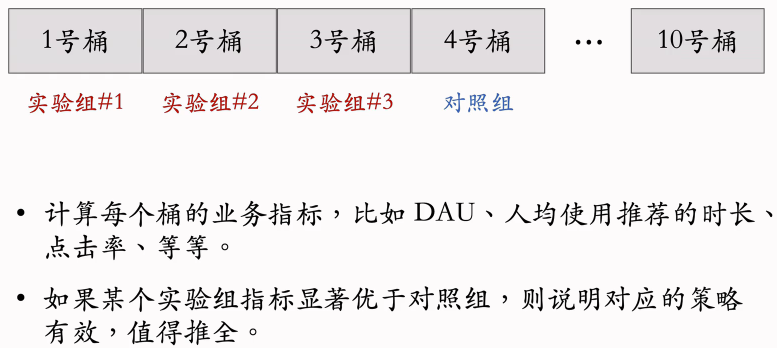
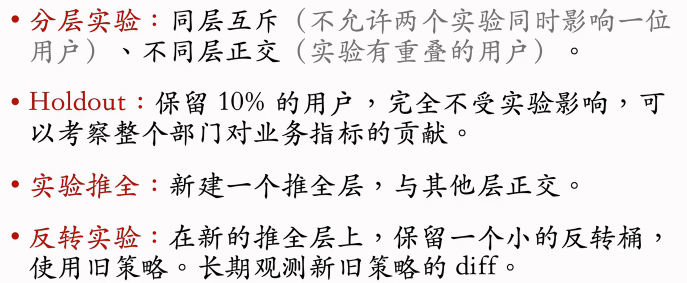
分层实验
分层实验的目标就是解决流量不够用的问题。
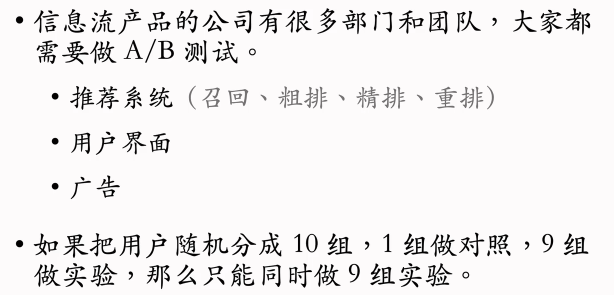
线上只能同时开9个A/B测试,根本无法满足产品迭代的需求,解决方案就是分层实验。
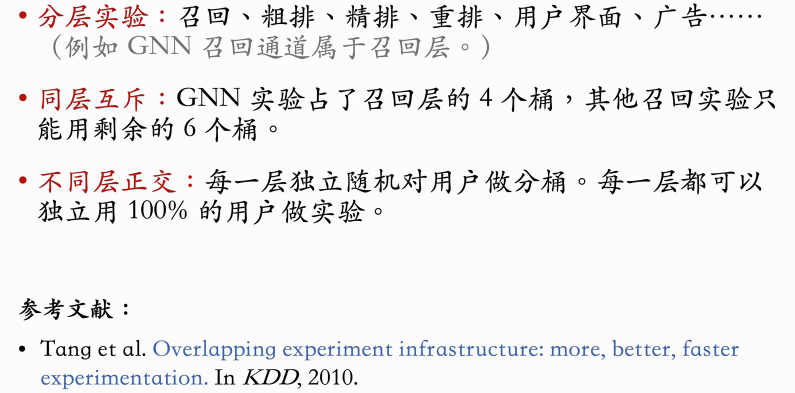
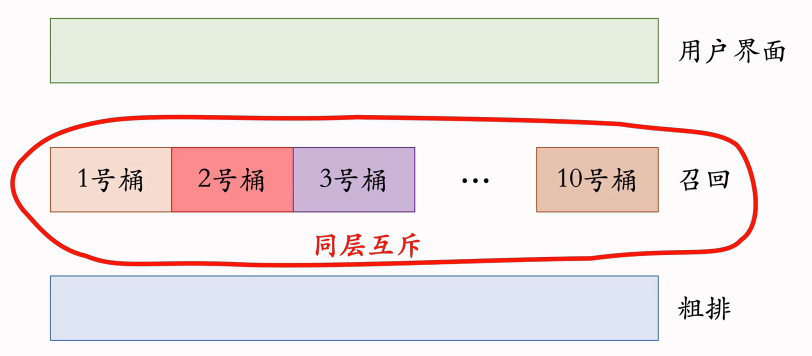
同层互斥
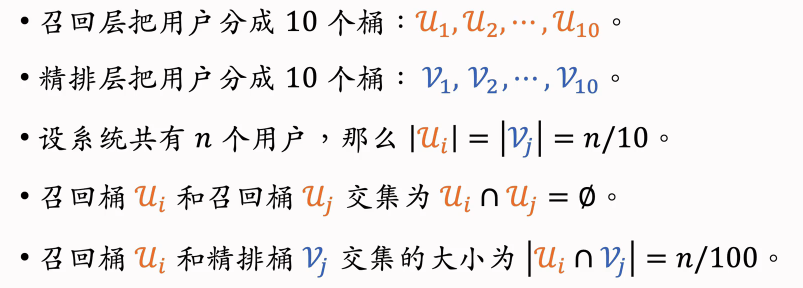
不同层正交
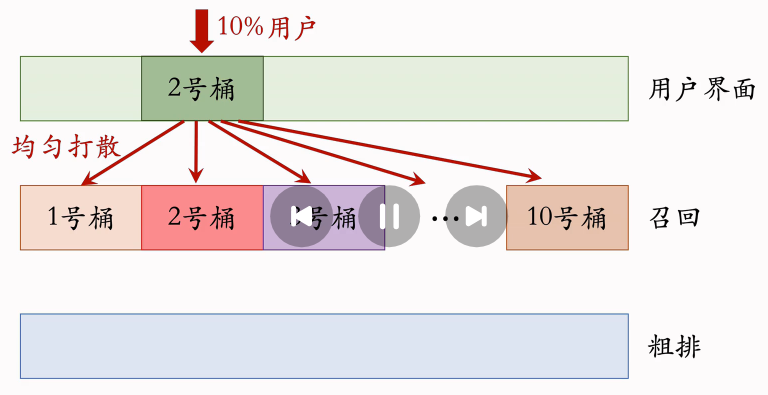
互斥vs正交
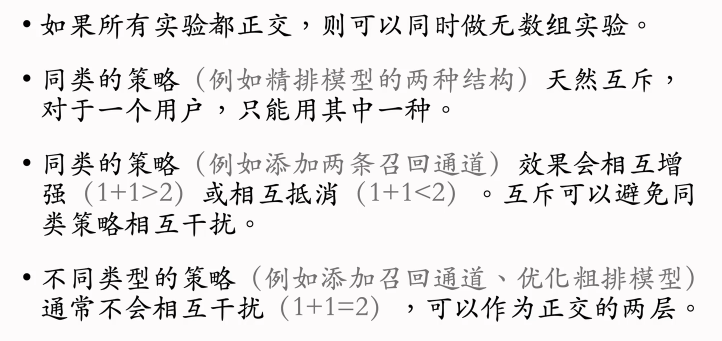
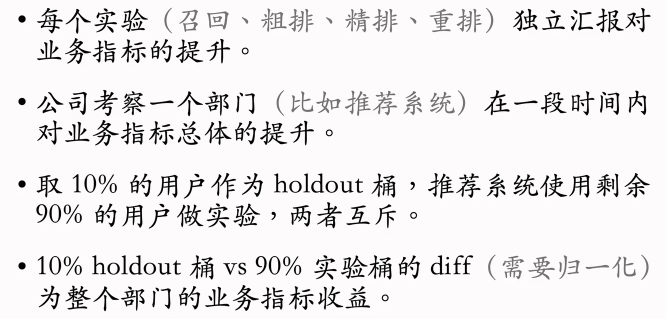
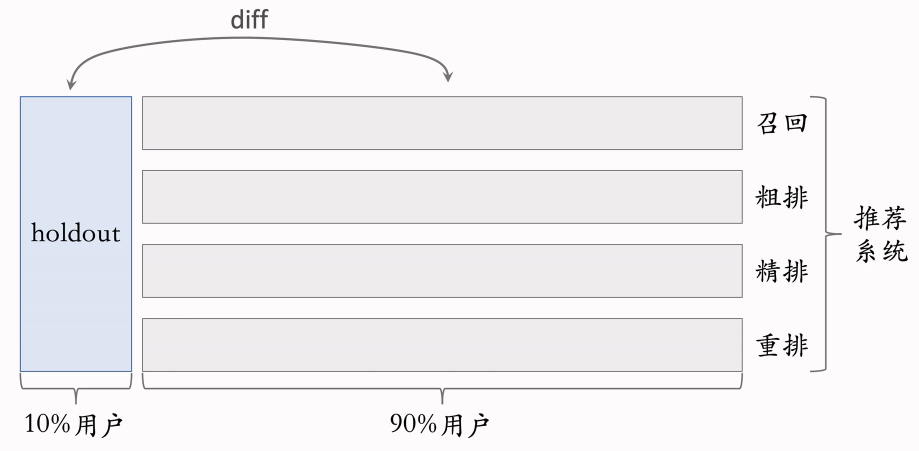
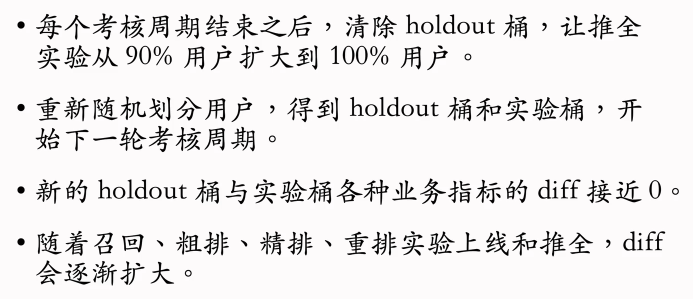
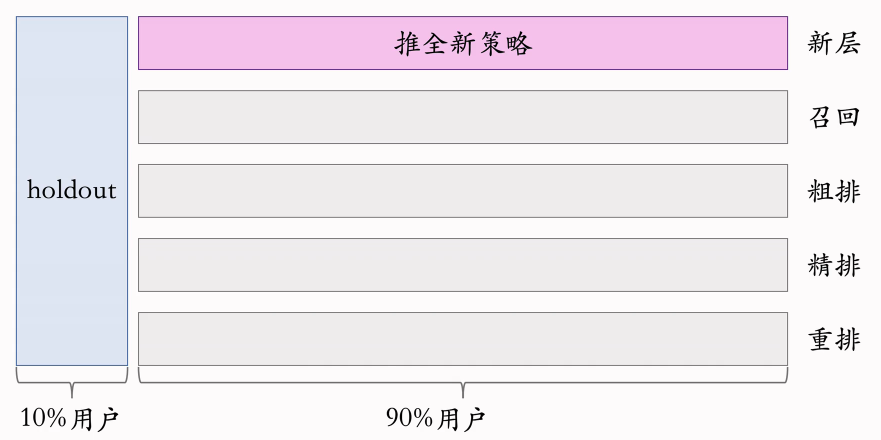
Holdout机制
实验推全&反转实验
实验推全
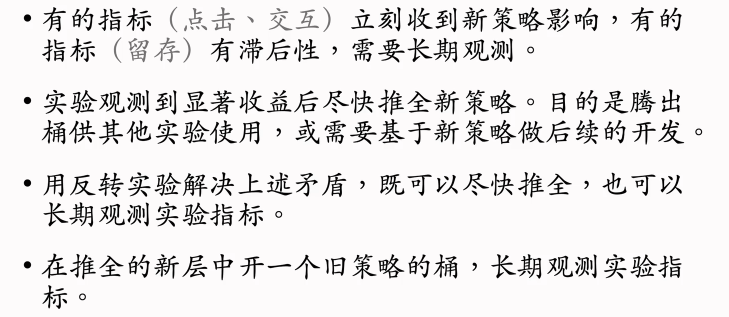
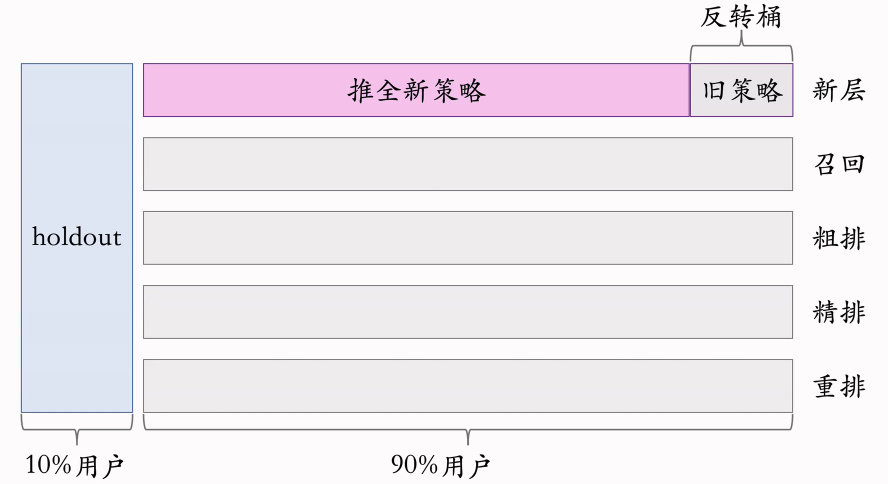
反转实验
总结
基于物品的协同过滤(ItemCF)
ItemCF的原理
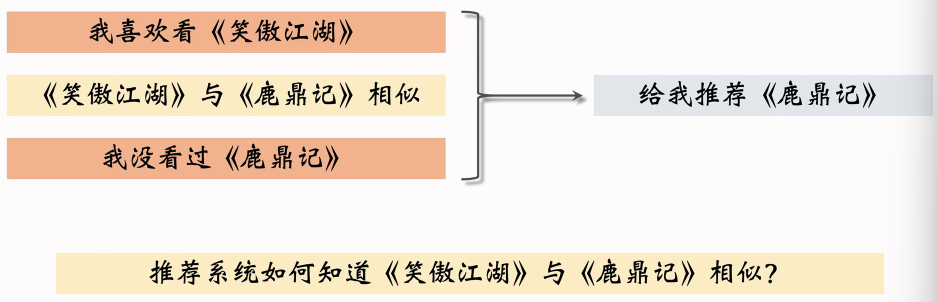
用知识图谱,两本书的作者相同,所以两本书相似;
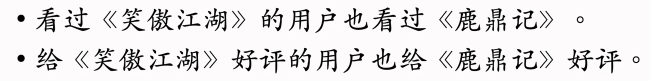
还可以基于全体用户的行为,判断两个物品的相似性,比如:
ItemCF的实现
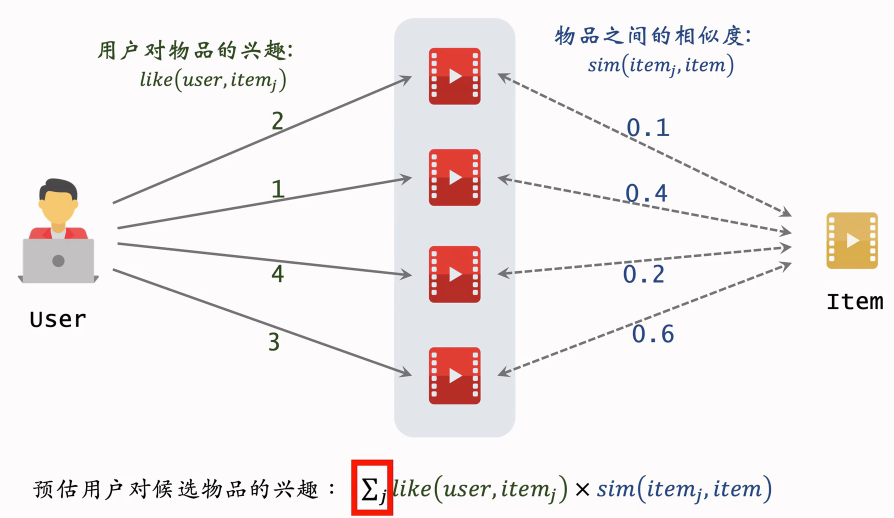
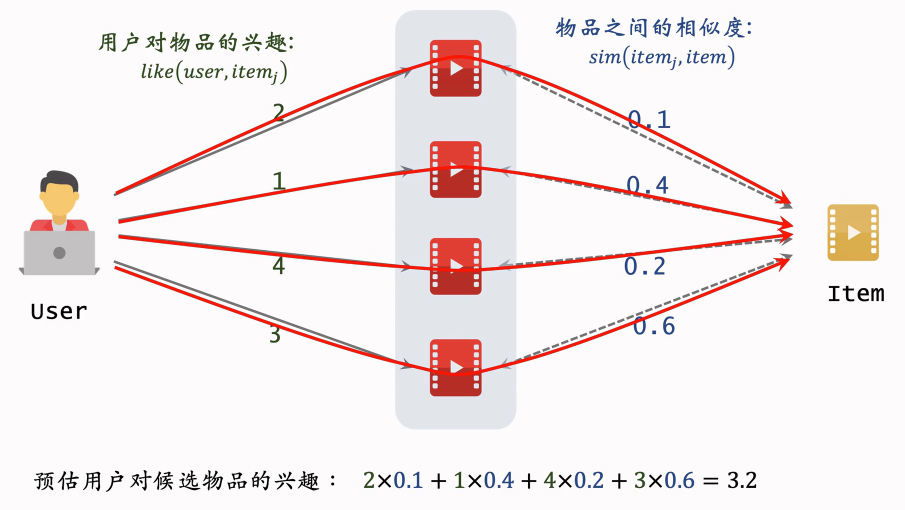
物品的相似度
可以从数据中挖掘出物品的相似度。
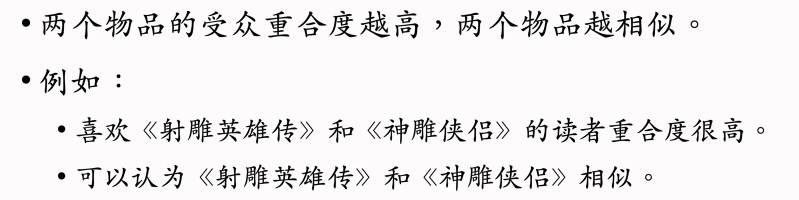
两个物品不相似:
红色和绿色这两个物品的用户没有重合,这意味这两个物品不相似。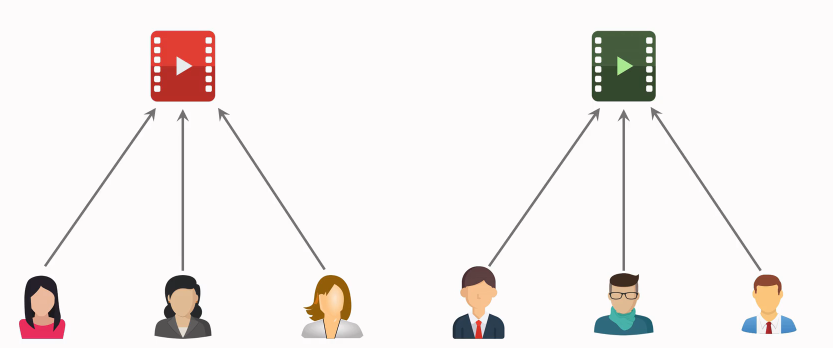
两个物品相似:
下面这两个物品的受众重合度非常高,判定为相似。
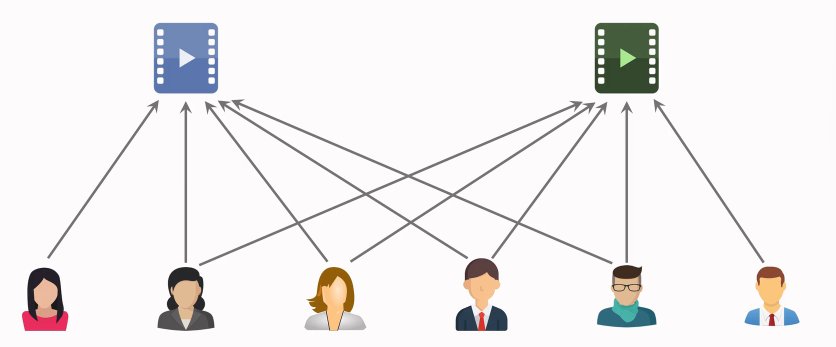
计算物品相似度:
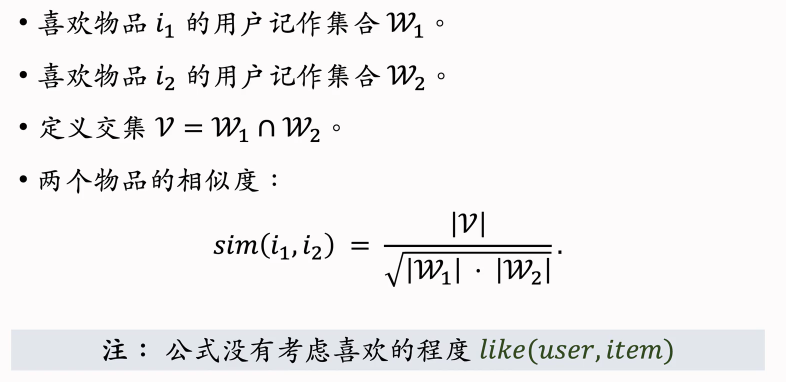
考虑喜欢程度:
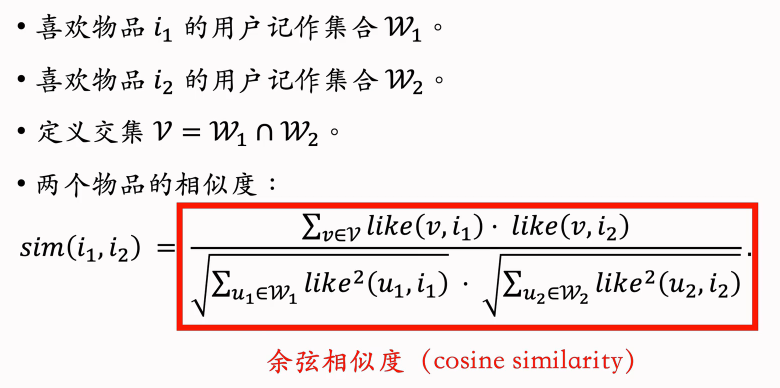
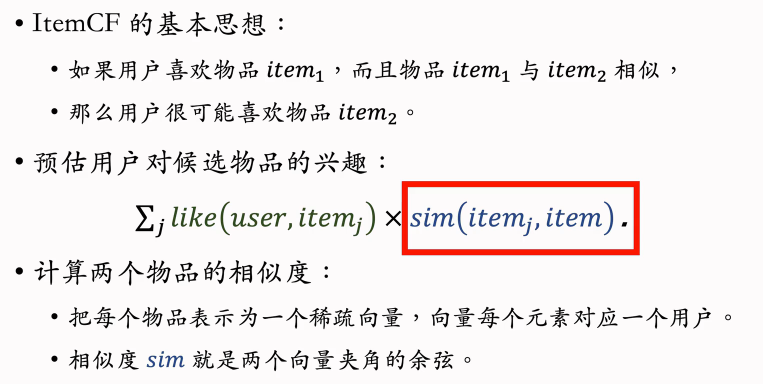
小结
ItemCF召回的完整流程
事先做离线计算
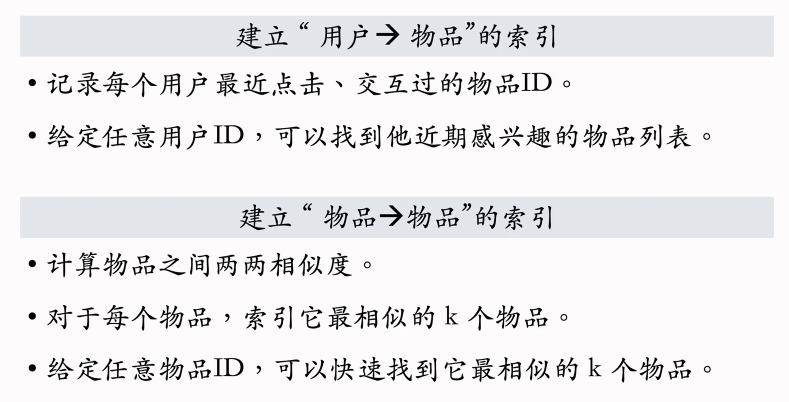
“用户→物品”的索引
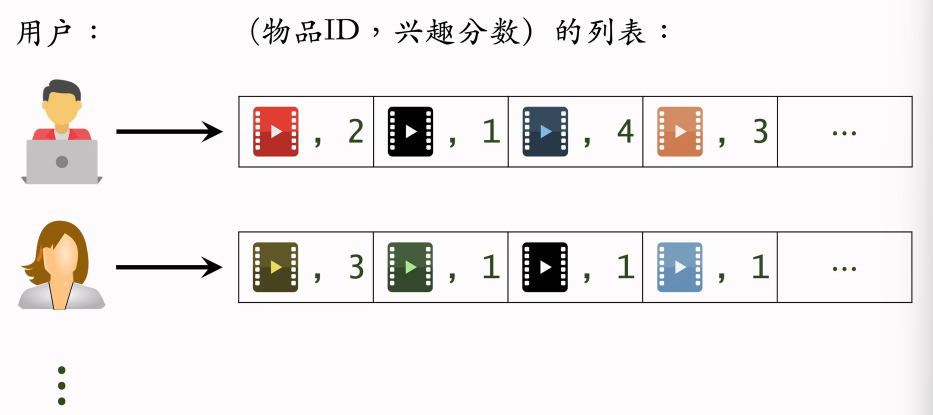
“物品→物品”的索引
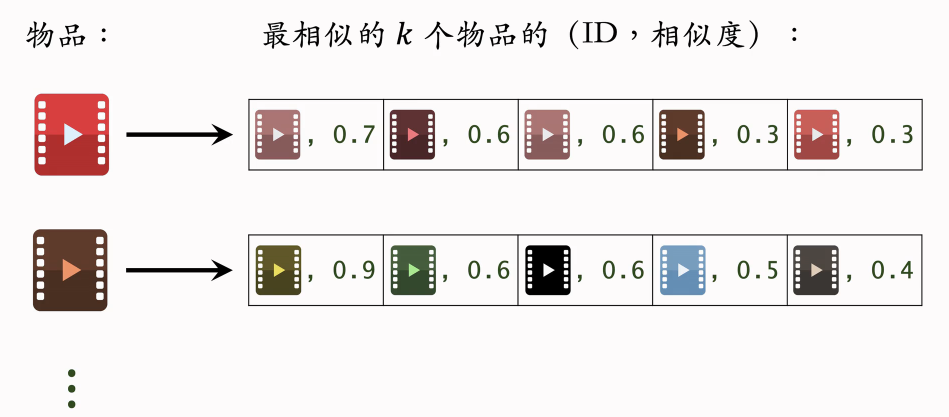
线上做召回
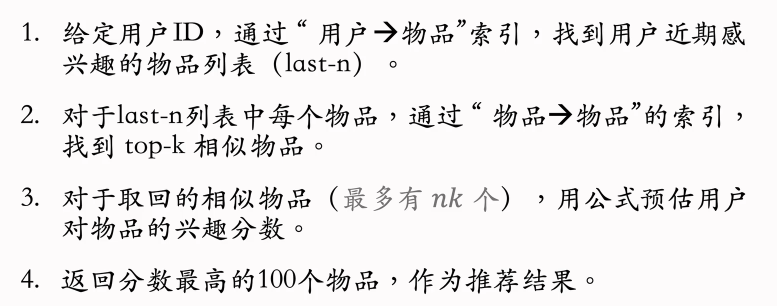
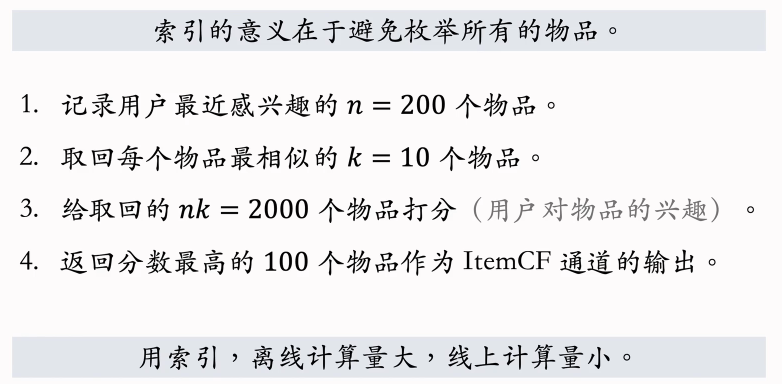
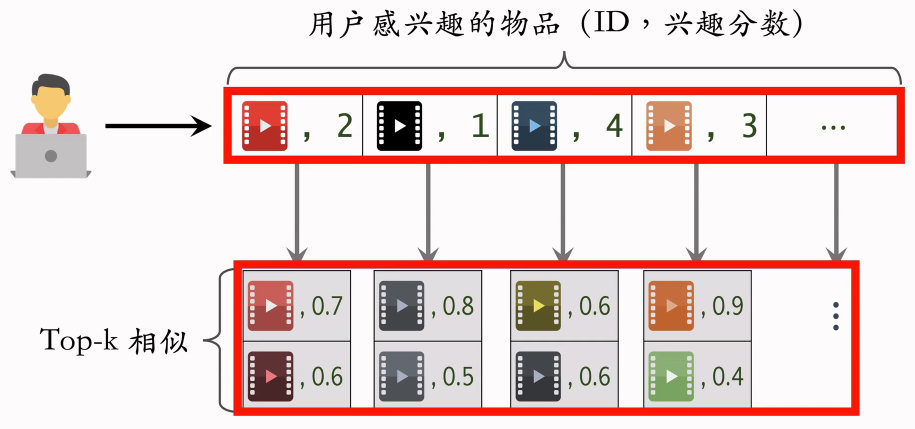
总结
ItemCF的原理
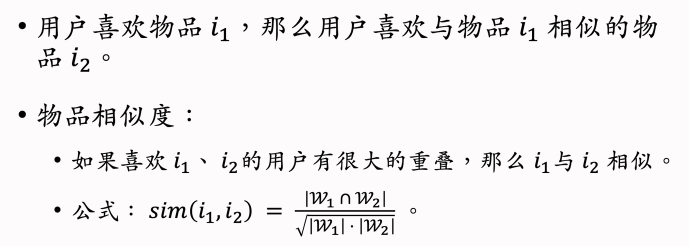
ItemCF召回通道
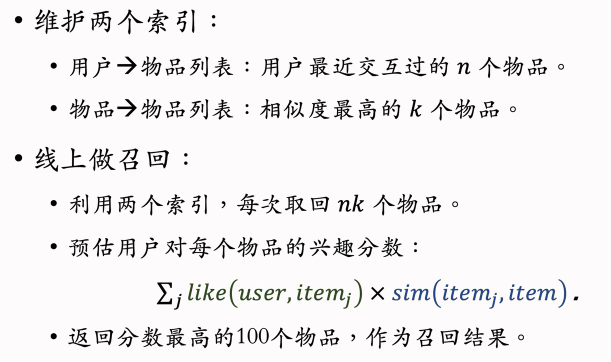
Swing召回通道
回顾ItemCF
ItemCF的原理
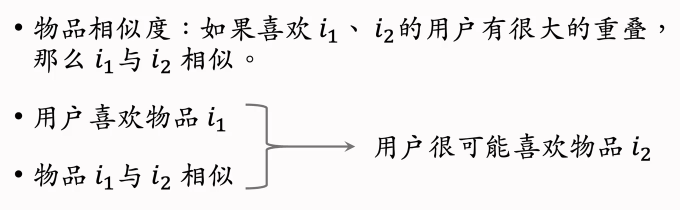
ItemCF的物品相似度
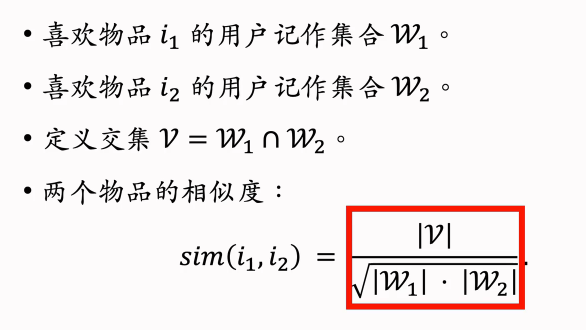
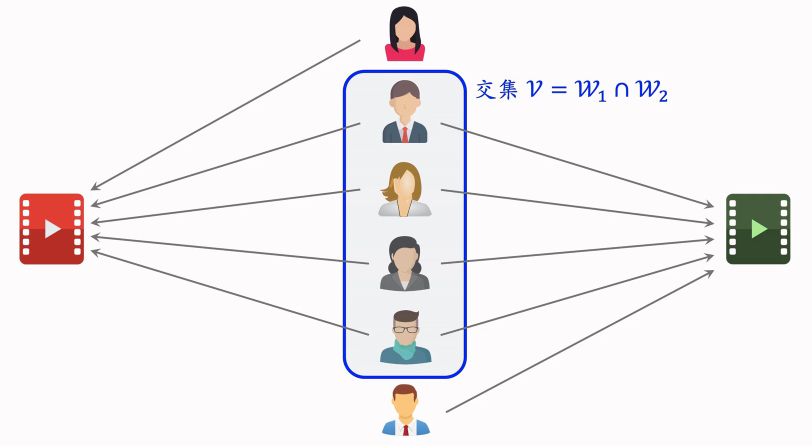
ItemCF的不足之处
假如重合的用户是一个小圈子......
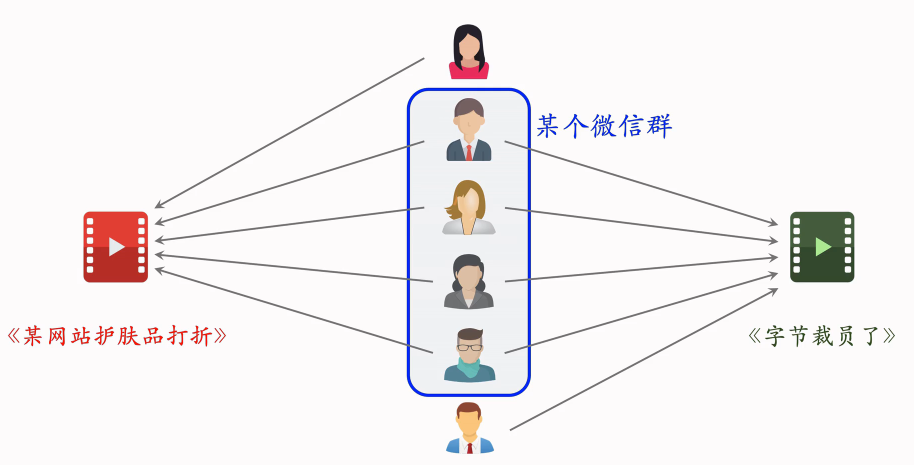
左右两篇笔记没有什么相似之处,它们的受众差别很大,但是两篇笔记碰巧同时被分享的同一个微信群里,微信群里有人同时点开这篇笔记。这样会造成两篇笔记的受众完全不同,但是很多用户同时交互过两篇笔记,导致系统错误地判断两篇笔记的相似度很高。
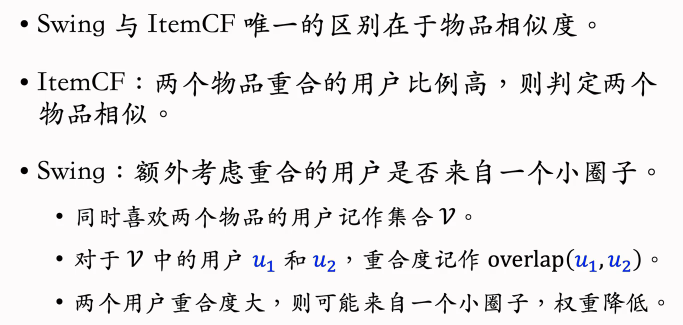
想要解决这个问题就要降低小圈子用户的权重。我们希望两个物品重合的用户广泛而且多样,而不是集中在一个小圈子里。一个小圈子里的用户同时交互两个物品,不能说明两个物品相似;相反,如果大量不相关的用户同时交互两个物品,则说明两个物品有相同的受众。
Swing模型的原理就是给用户设置权重,解决小圈子问题。
Swing模型
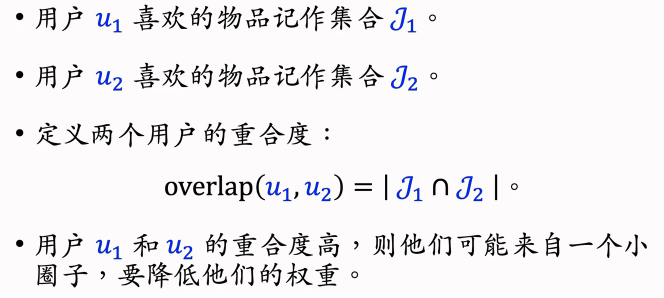
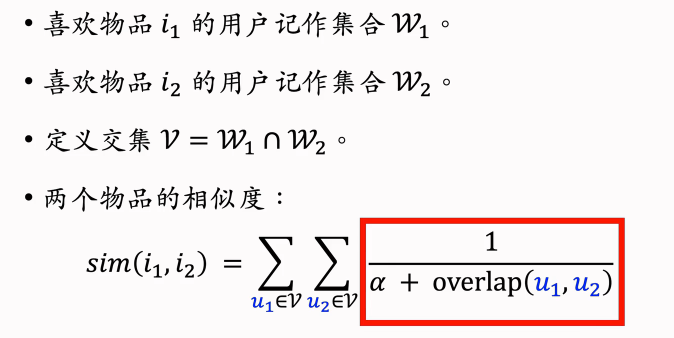
用overlap可以降低小圈子对相似度的影响。
总结
基于用户的协同过滤(UserCF)
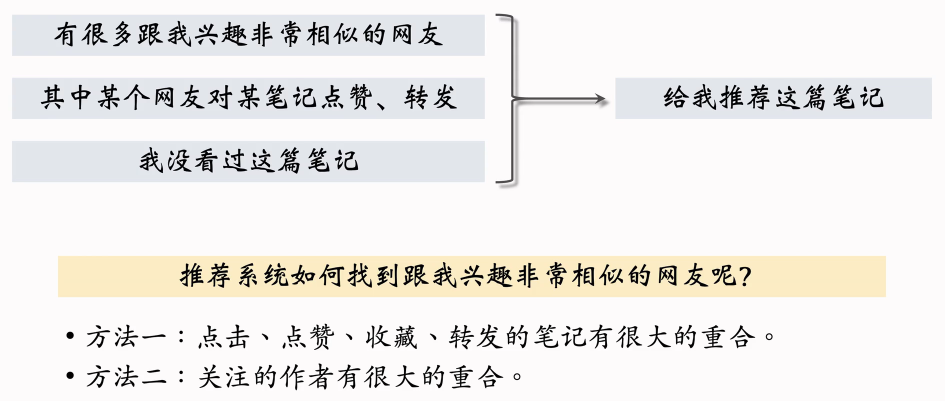
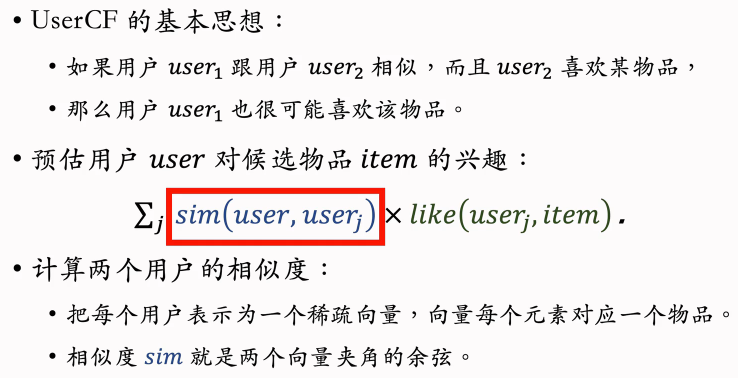
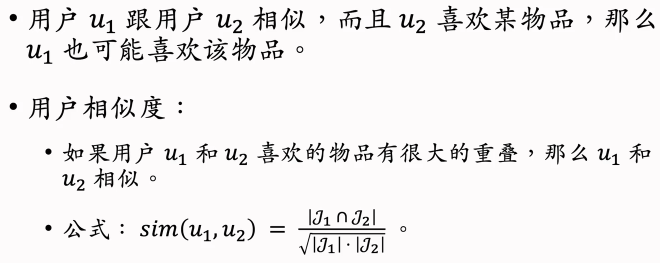
UserCF的原理
UserCF的实现
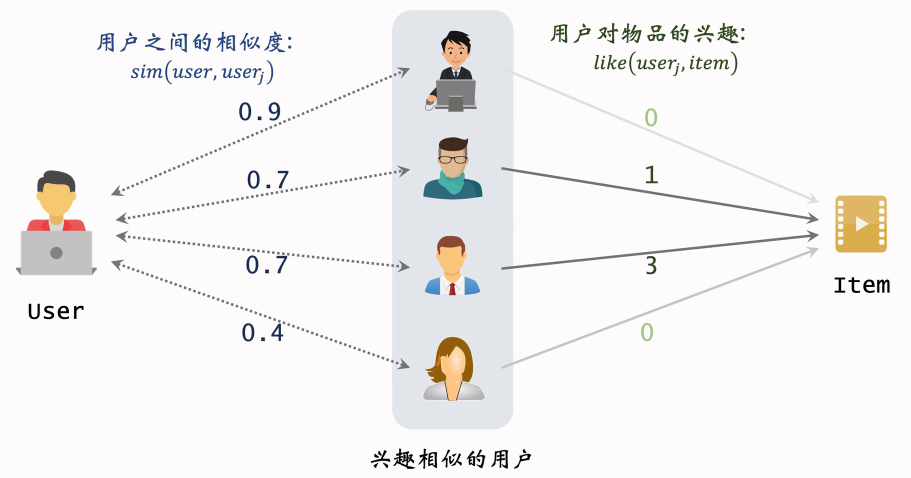
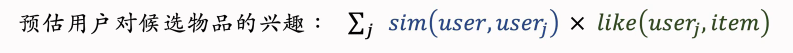
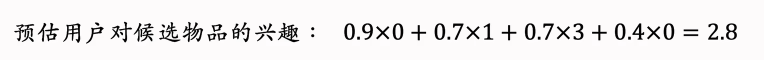
用户的相似度
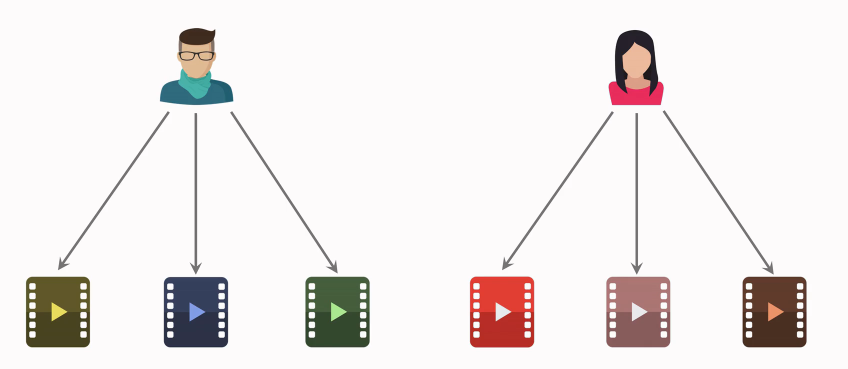
两个用户不相似
他们喜欢的物品没有重合
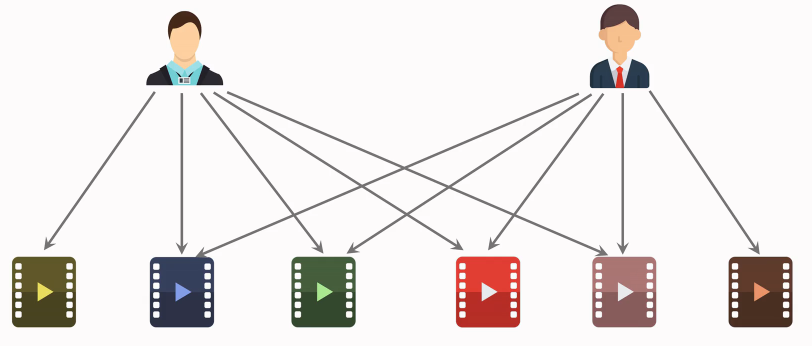
两个用户相似
两个用户喜欢的物品重合度非常高
计算用户相似度
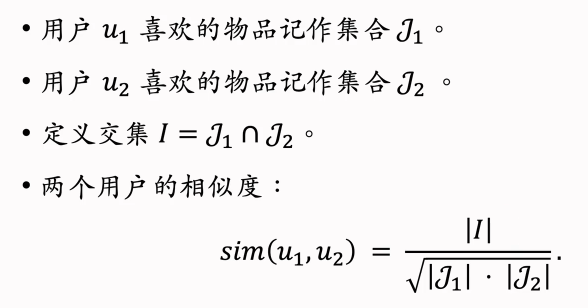
公式的不足之处:公式同等对待热门和冷门的物品,这是不对的。
降低热门物品权重
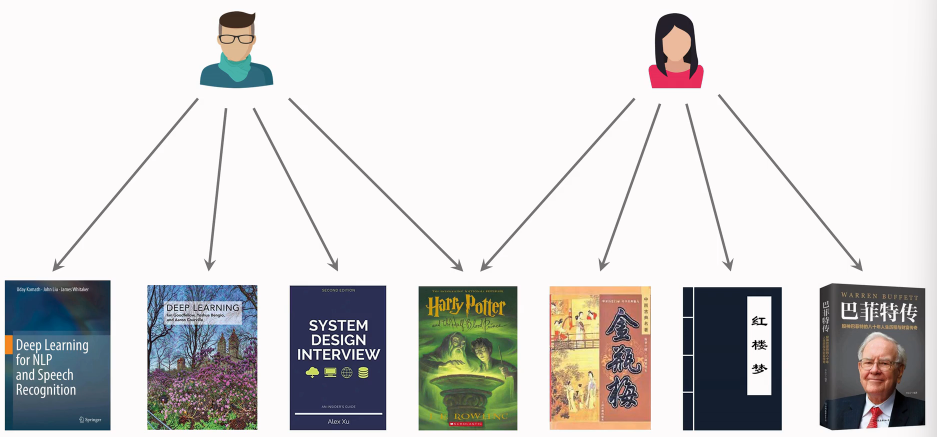
《哈利波特》是非常热门的物品,无论是大学教授还是中学生,都喜欢看《哈利波特》。既然都喜欢看《哈利波特》,那么《哈利波特》对于计算用户相似度是没有价值的。
越热门的物品越无法反映用户最独特的兴趣,对计算相似度就没有用;相反,重合的物品越冷门,越能反映用户的兴趣。
如果两个人都很喜欢《deep learning》这本书,说明两个人很有可能是同行;如果两个人都喜欢更冷门一些的书,比如《深度学习在语音识别中的应用》,说明两个人是小同行。
为了更好地计算用户兴趣的相似度,我们需要降低热门物品的权重。
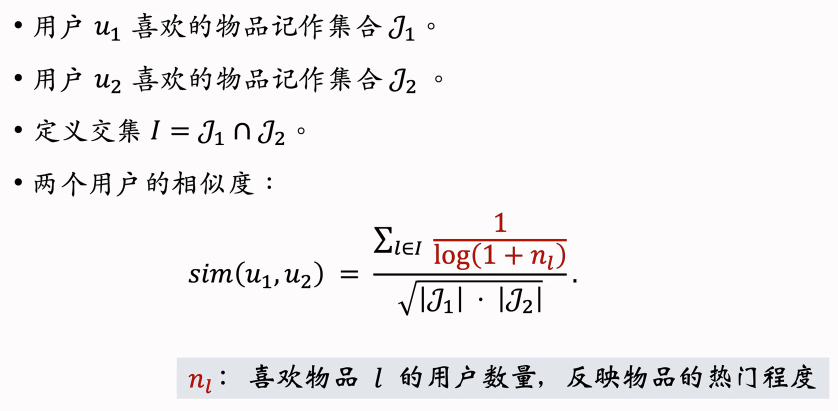
物品越热门 n~l~ 就越大 ,也就是说物品的权重越小。
小结
UserCF召回的完整流程
事先做离线计算
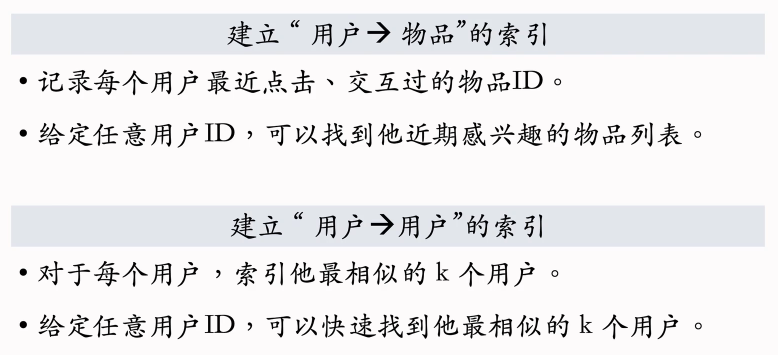
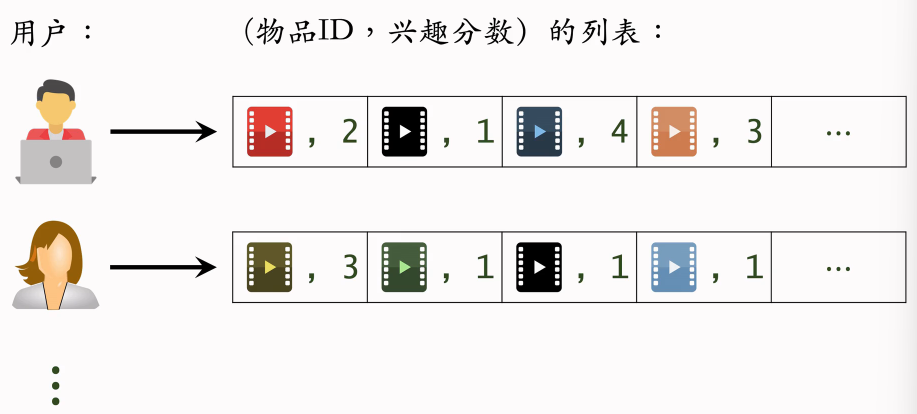
“用户→物品”的索引
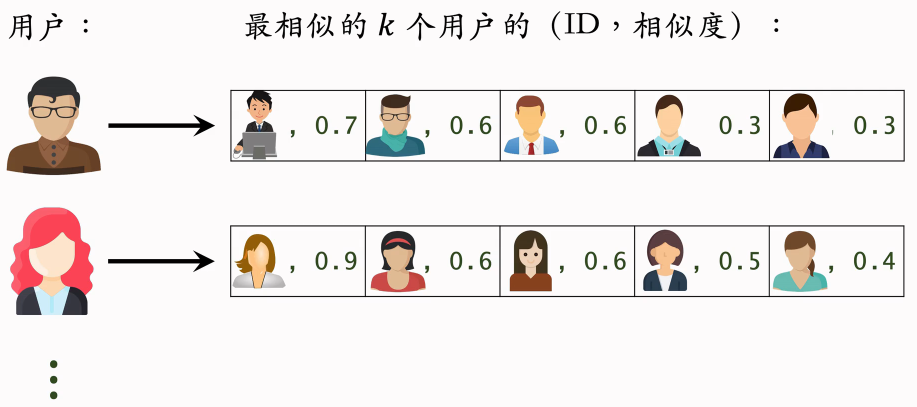
“用户→用户”的索引
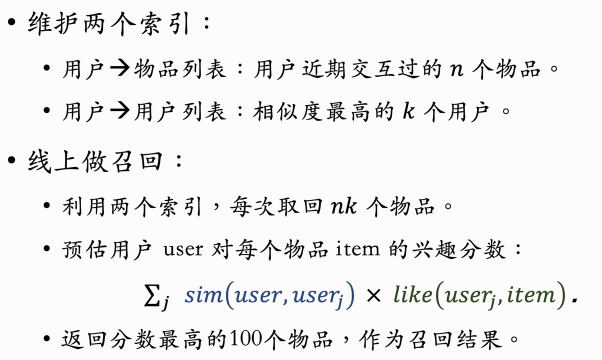
线上做召回
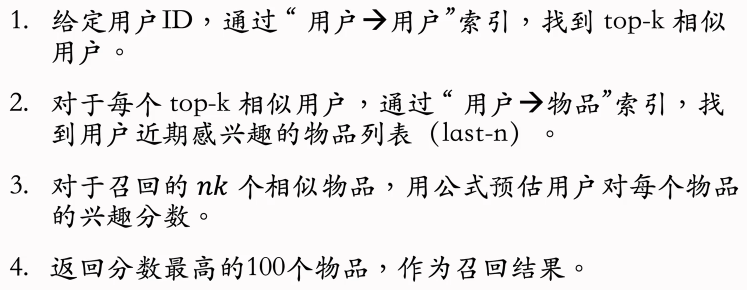
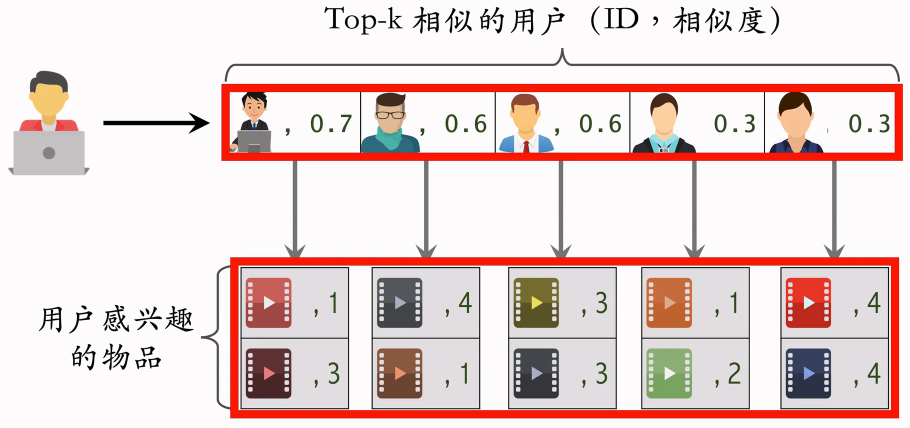
如果取回的物品有重复的,就做去重,把分数加起来。
总结
UserCF的原理
UserCF召回通道
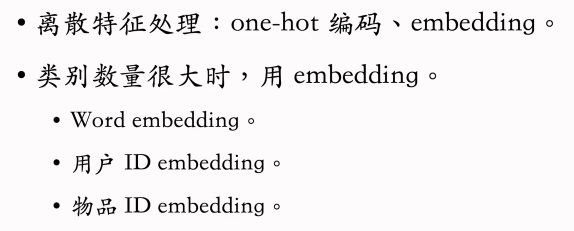
离散特征处理
前面几节课讲解了协同过滤的召回方法,后面几节课要介绍向量召回。
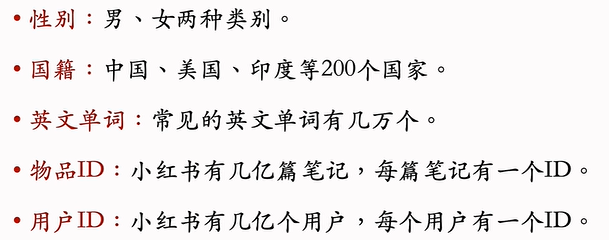
离散特征
离散特征处理
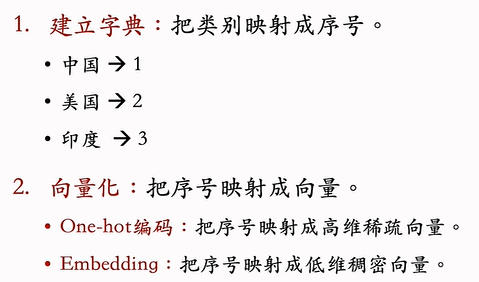
One-Hot 编码
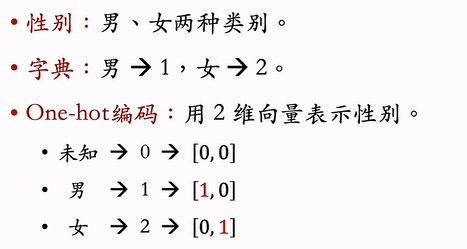
例1:性别特征
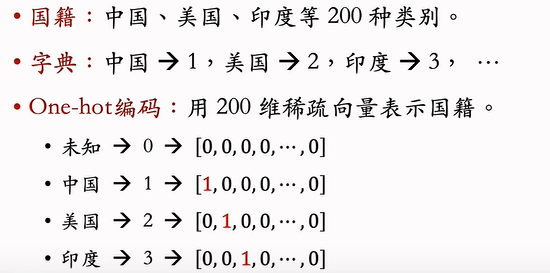
例2:国籍特征
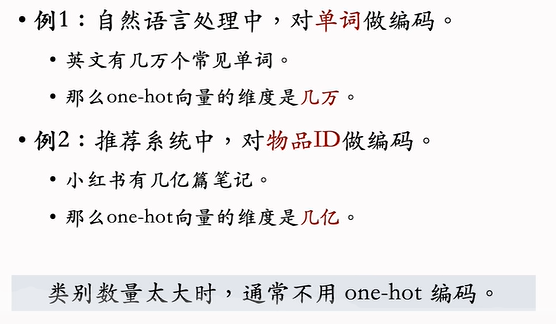
One-Hot编码的局限
Embedding(嵌入)
例1:国籍的Embedding
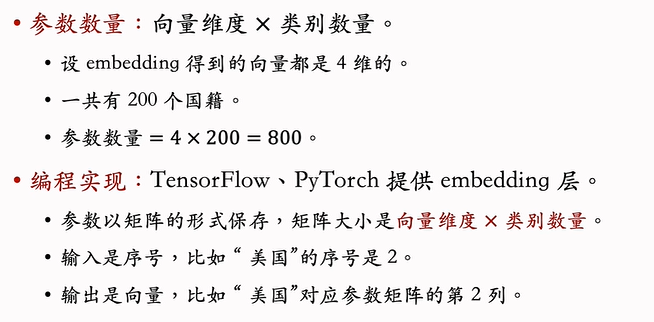
在训练神经网络时,会自动做反向传播,学习Embedding层的参数。
例2:物品ID的Embedding
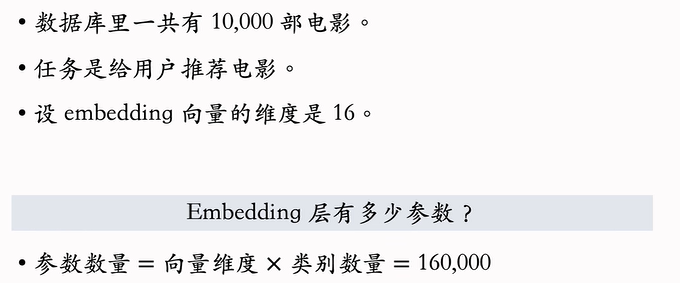
如果类别的数量不大,只有几百万,那么Embedding层的实现是比较容易的,TensorFlow和PyTorch都可以处理的很好;但是如果类别数量特别大,比如推荐系统中的物品数量有几十亿,那么Embedding层会特别大。
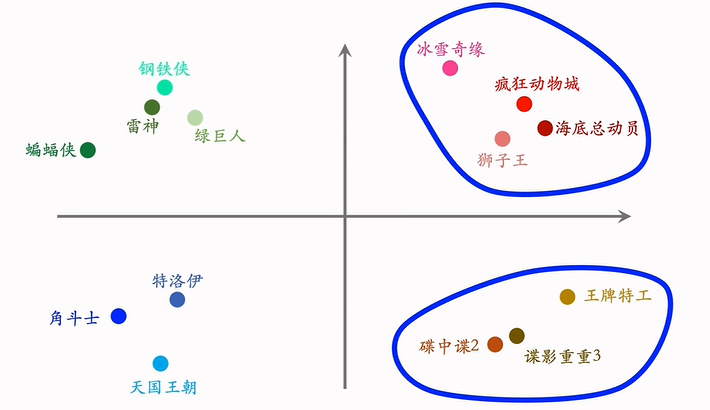
一个神经网络绝大多数参数都在Embedding层,所以工业界深度学习系统都会对Embedding层做很多优化,这是存储和计算效率的关键所在。
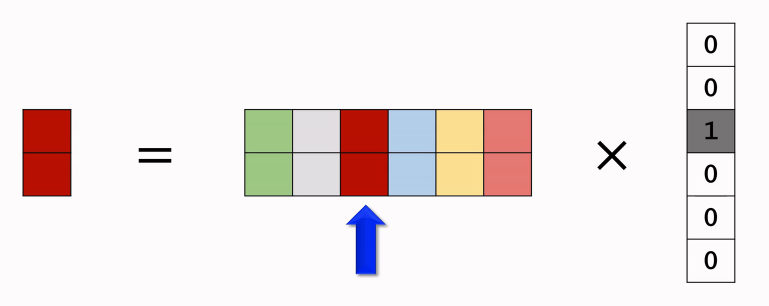
Embedding = 参数矩阵 × One-Hot向量
总结
矩阵补充(Matrix Completion)
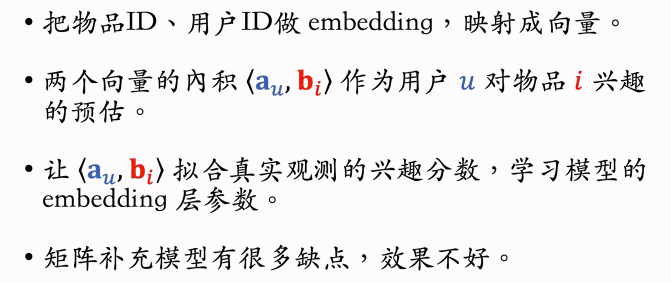
矩阵补充是向量召回最简单的一种方法,但是现在已经不太常用这种方法了,此处讲解矩阵补充是为了方便理解下节课的双塔模型。
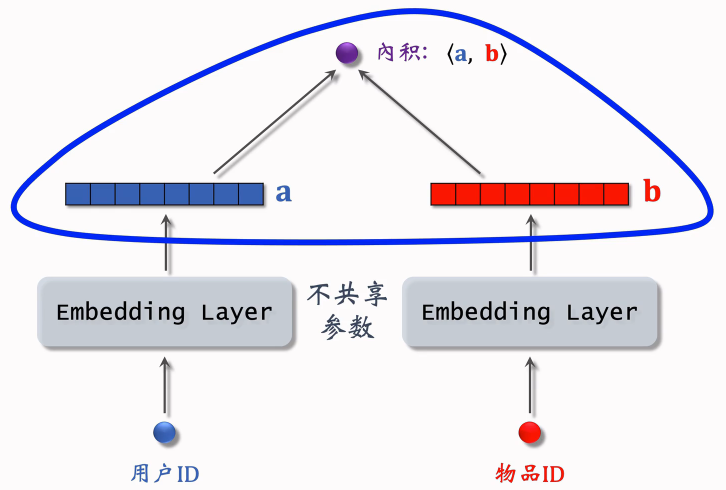
训练
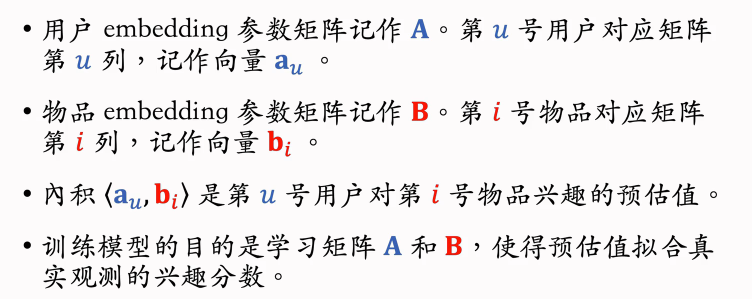
基本想法
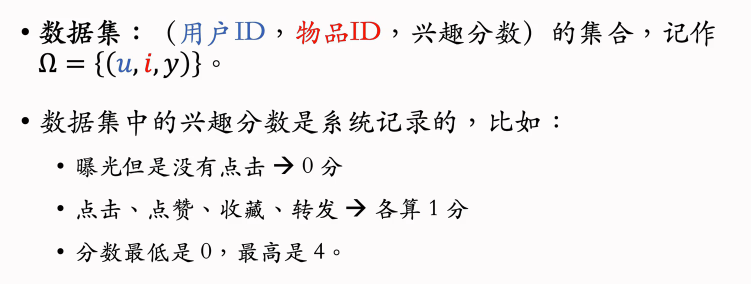
数据集
训练
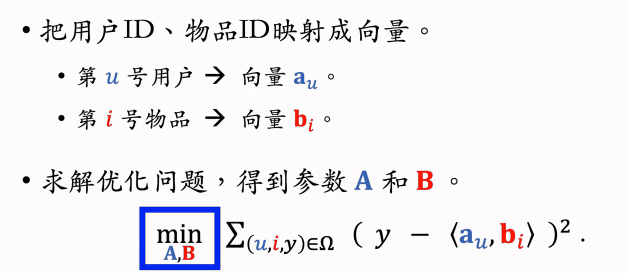
求最小化可以用随机梯度下降等算法,每次更新矩阵A和B的一列,这样就可以学出矩阵A和B。
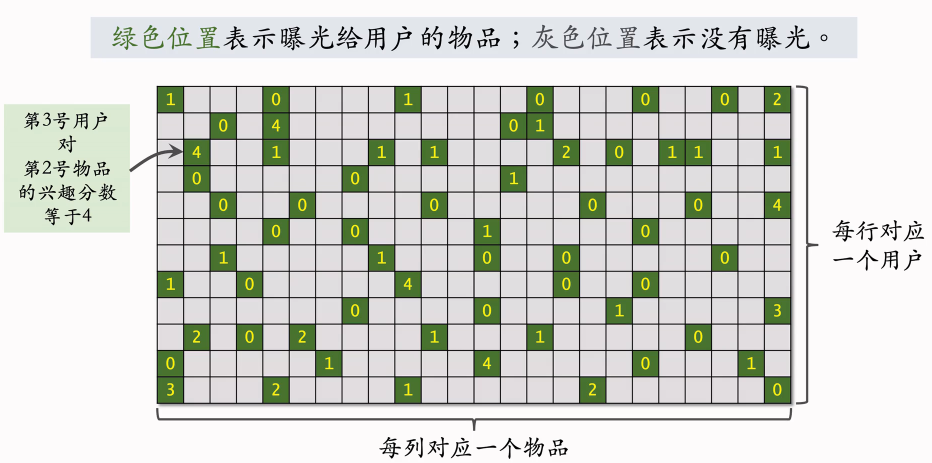
矩阵中只有少数位置是绿色,大多数位置都是灰色(也就是没有曝光给用户的),我们并不知道用户对没曝光的物品是否感兴趣。
我们刚才用绿色位置的数据训练出了模型,有了模型就可以预估出所有灰色位置的分数,也就是发矩阵的元素补全,这就是为什么模型叫做矩阵补充。
把矩阵元素补全之后就可以做推荐,给定一个用户,我们选出所对应的行中,分数较高的物品,推荐给该用户。
在实践中的效果不好……
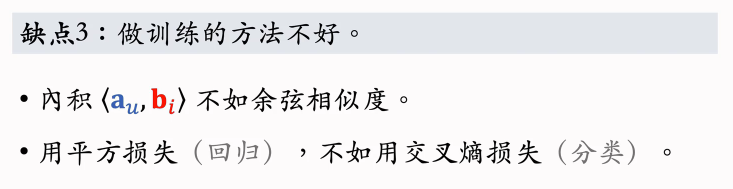
线上服务
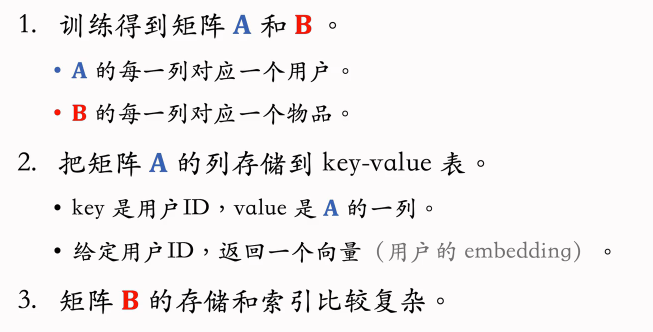
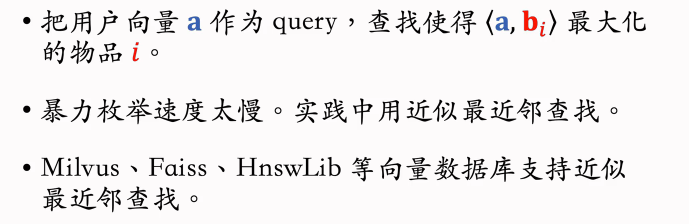
在训练好模型之后,可以把模型用作推荐系统中的召回通道,比如在用户刷小红书的时候,快速找到这个用户可能感兴趣的一两百篇笔记。
模型存储
在做完训练之后,把模型存储在正确的地方,便于做召回。
线上服务
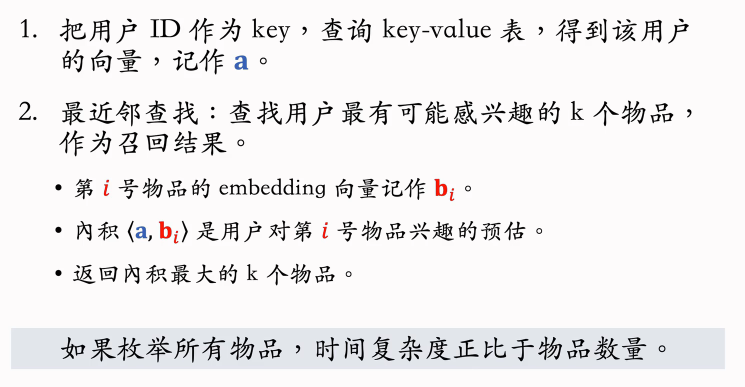
近似最近查找(Approximate Nearest Neighbor Search)
支持最近邻查找的系统
快速最近邻查找的算法已经被集成到很多向量数据库系统中。
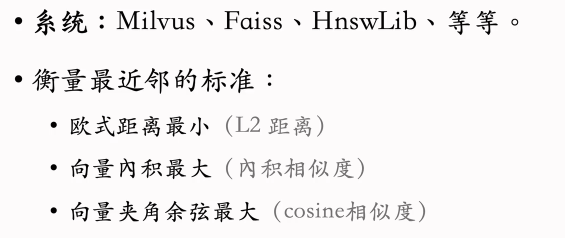
有些系统不支持余弦相似度,这也很好解决:把所有向量都做归一化,让他们的二范数全都等于1,那么内积就等于余弦相似度。
用一个直观的例子来演示最近邻查找:
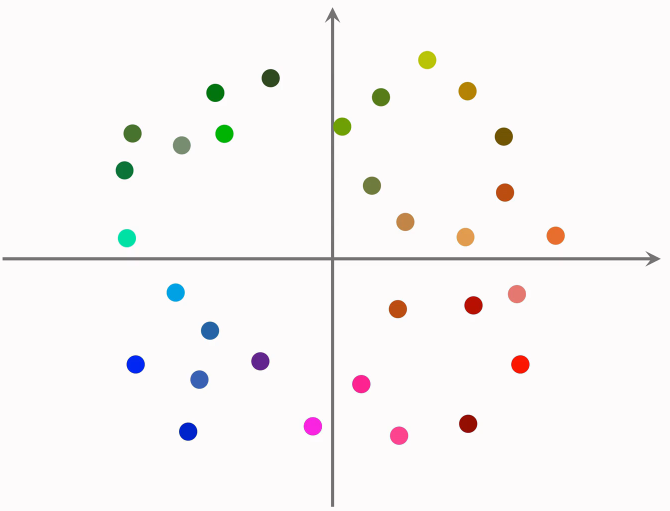
这是一个散点图,每个点是物品的Embedding向量(都是训练模型时训练出来的);右边的五角星是用户的Embedding向量,记做a。
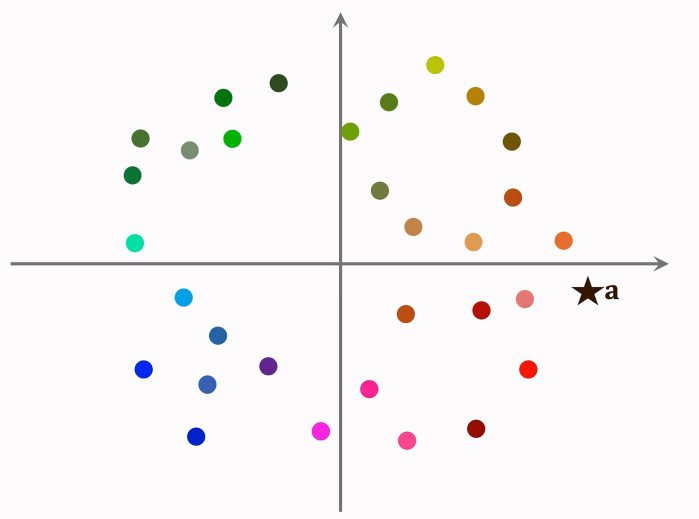
我们想要召回用户可能感兴趣的物品,这就需要计算这个向量和所有点的相似度。如果用暴力枚举的话,计算量正比于点的数量(也就是物品的数量)。想要减少最近邻查找的计算量必须要避免暴力枚举。
一种加速最近邻查找的算法:在做线上服务之前,先对数据做预处理,把数据划分成很多区域,比如以下划分(至于如何划分,取决于衡量最近邻的标准):
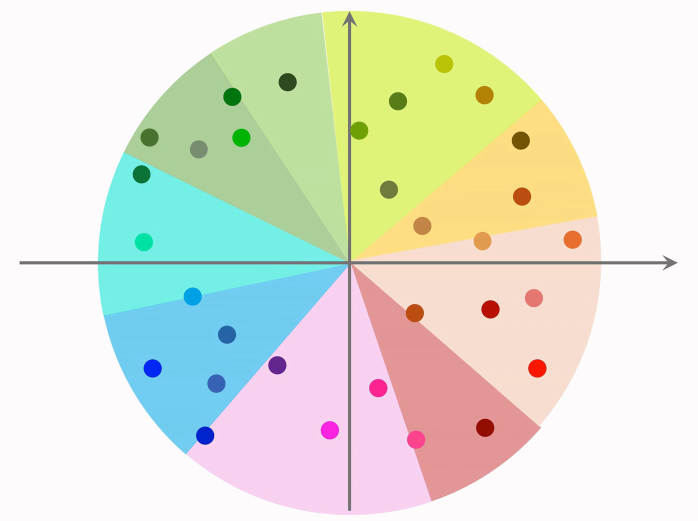
如果cosine相似度,那么划分的结果就是以上的扇形;如果使用欧氏距离,那么划分的结果就是多边形。划分之后每个区域用一个向量表示,比如以下蓝色,黄色区域,用向量表示:
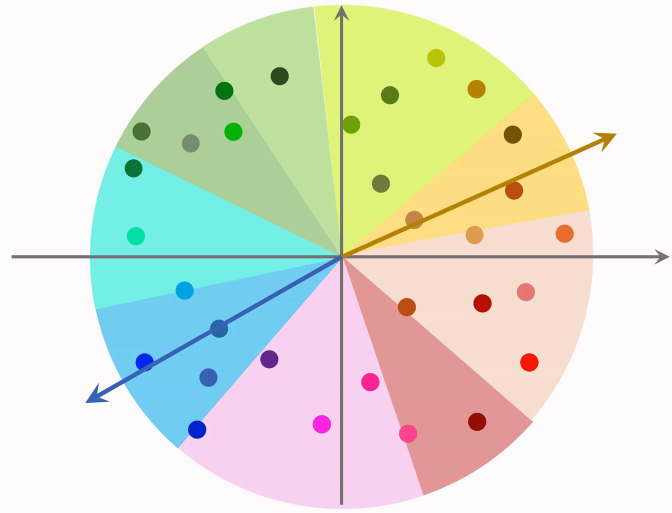
这些向量的长度都是1,划分区域之后建立索引,把每个区域的向量作为key,把区域中所有点的列表作为value。划分区域之后每个区域都用一个单位向量来表示。
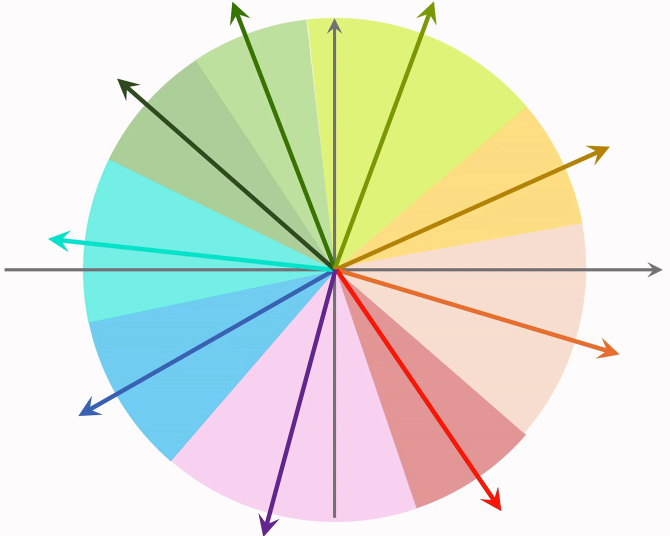
假如有一个点,划分成一万个区域,索引上一共有一万个key值,每个向量是一个区域的key值,给定一个向量,可以快速取回这个区域内所有的点。有了这样的索引就可以在线上快速做召回了。
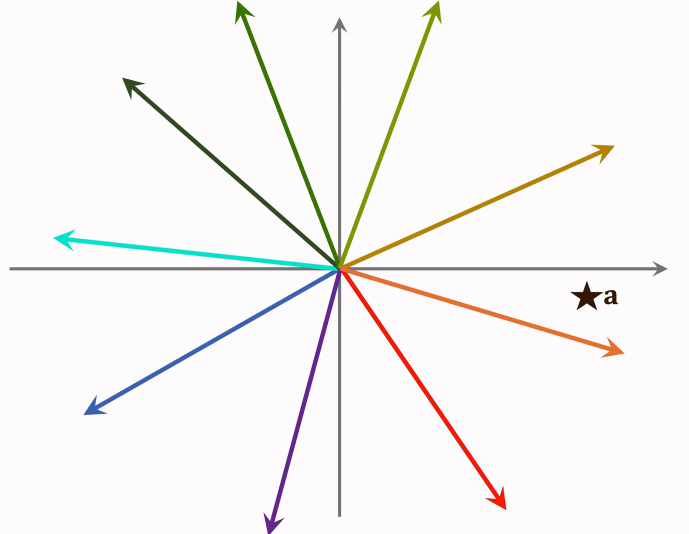
在线上给一个用户做推荐,这个用户的embedding向量记做a。首先把向量a和索引中的这些向量作对比,计算他们的相似度。如果物品数量是几亿,索引中的数量也只有几万而已,这一步的计算开销不大。
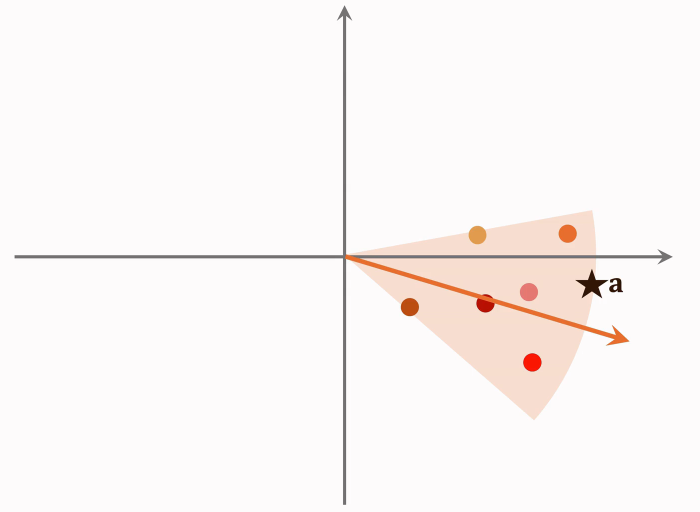
计算相似度之后,会发现a下面最靠近a的向量和a最相似,通过索引找到这个区域内所有的点,每个点对应一个物品;接下来计算点a和区域内所有点的相似度,如果有几亿个物品被划分到了几万个区域平均每个区域只有几万个点,所以这一步只需要计算几万次相似度,计算量也不大。
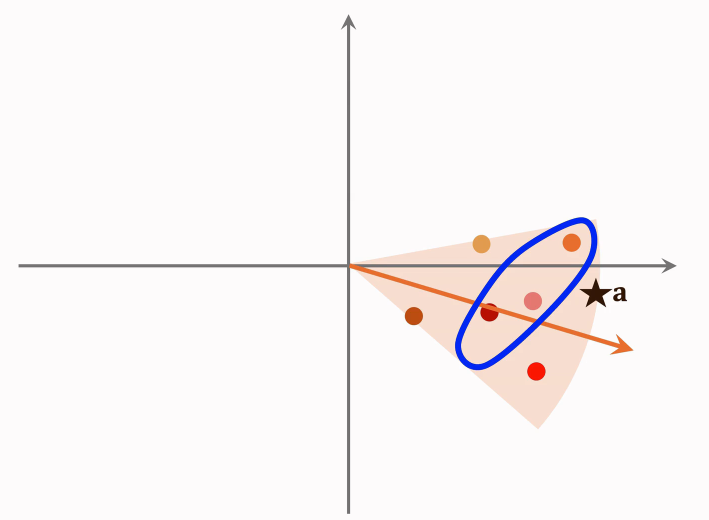
假如要找和向量a最相似的三个点,也就是夹角最小的三个点,就会找到圈住的这三个,对应三个物品,这三个物品就是最近邻查找的结果。
总结
矩阵补充
线上召回
双塔模型:模型和训练
矩阵补充模型
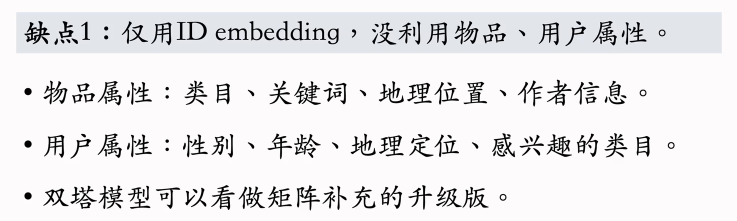
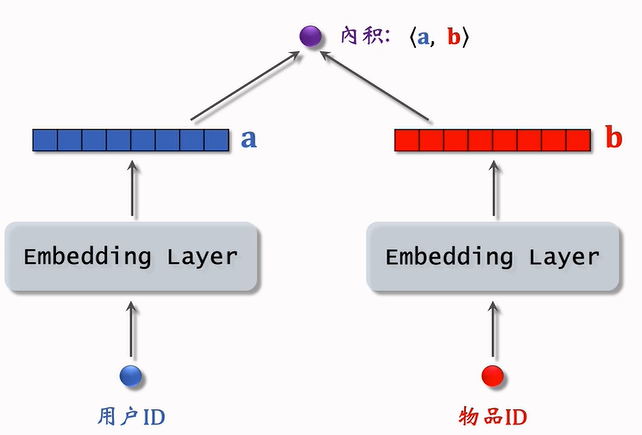
用内积来预估用户对物品的兴趣分数。这个模型比较弱,只用到了用户和物品的ID,没有用到用户和物品的属性。双塔模型可以看做是矩阵补充模型的升级。
双塔模型
对于用户连续特征,最简单的是做归一化,让特征均值为0,标准差是1
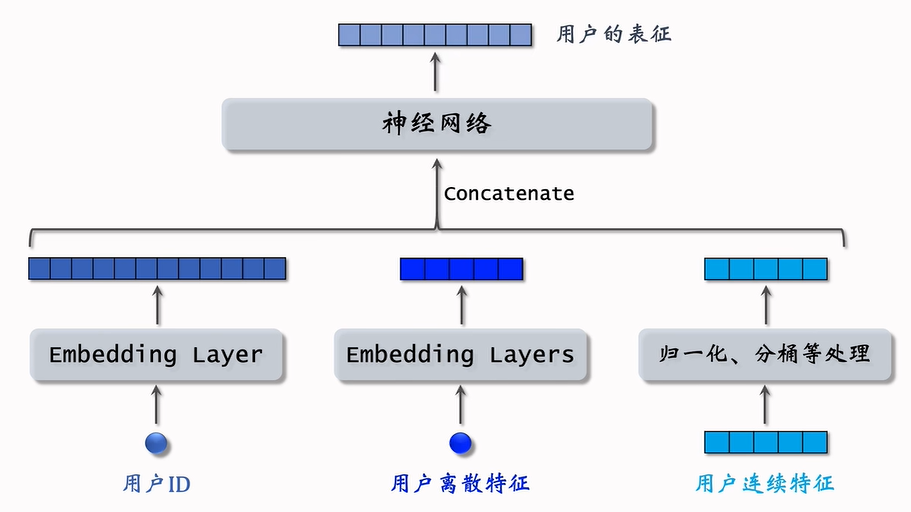
物品的特征也是用类似的方法:
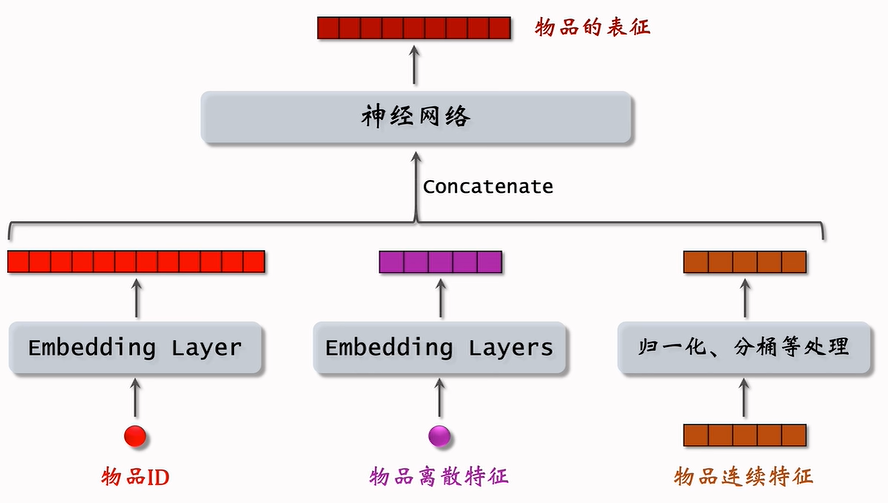
双塔模型
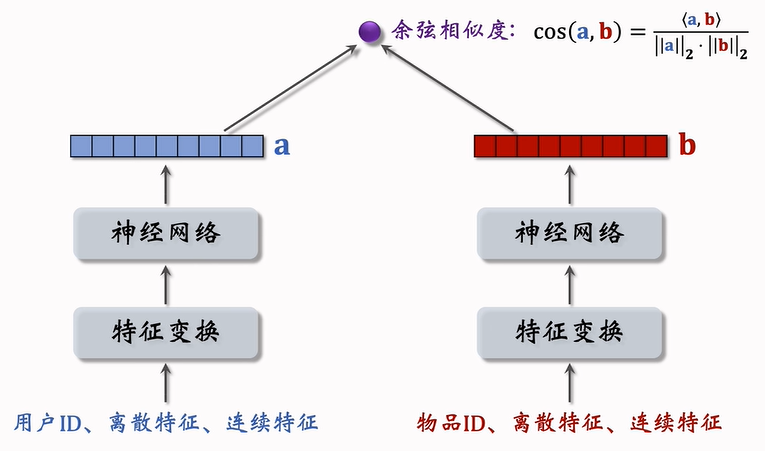
余弦相似度,意思是两个向量夹角的余弦值,相当于先对两个向量做归一化。余弦相似度的大小介于-1到1之间。
双塔模型的训练
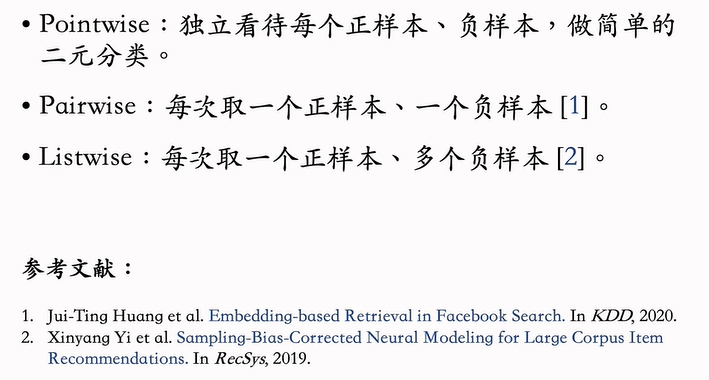
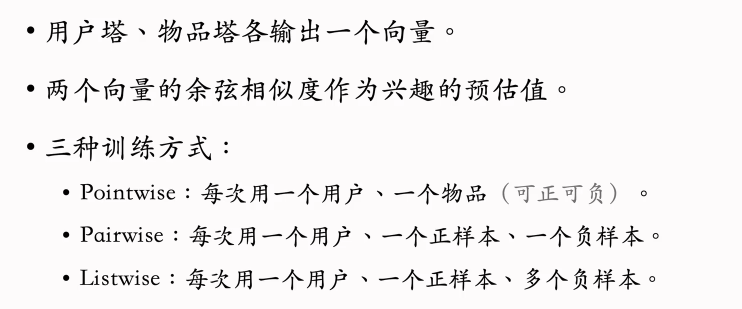
Pointwise:把正负样本组成一个数据集,在数据集上做随机梯度下降训练双塔模型
Pairwise:每次取一个正负样本组成一个二元组,损失函数用Triplet hinge Loss, 或者Triplet Logistic Loss,可以参考Facebook发的论文。
Listwise:组成一个list,训练方式类似于多元分类,参考YouTube发的论文。
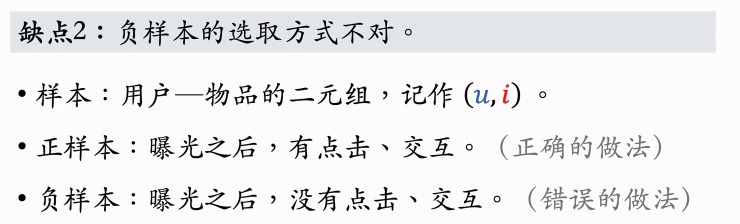
正负样本的选择
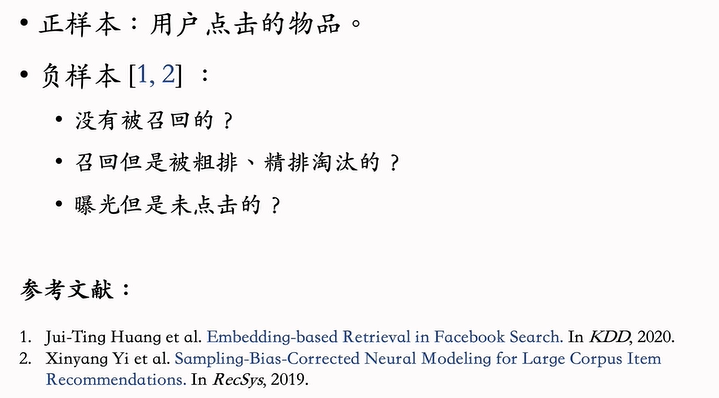
Pointwise训练
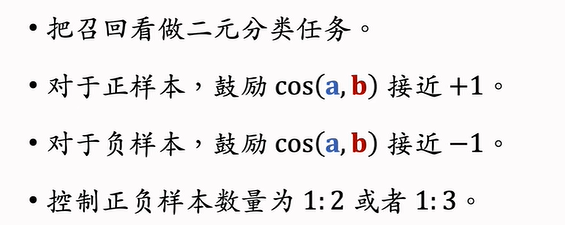
不知道为什么要控制正负样本比在1:2或者1:3,但是互联网大厂都是这么做的,可能是业内的经验。
pairwise训练
两个物品塔是相同的,里面的Embedding层和全连接层都用一样的参数。
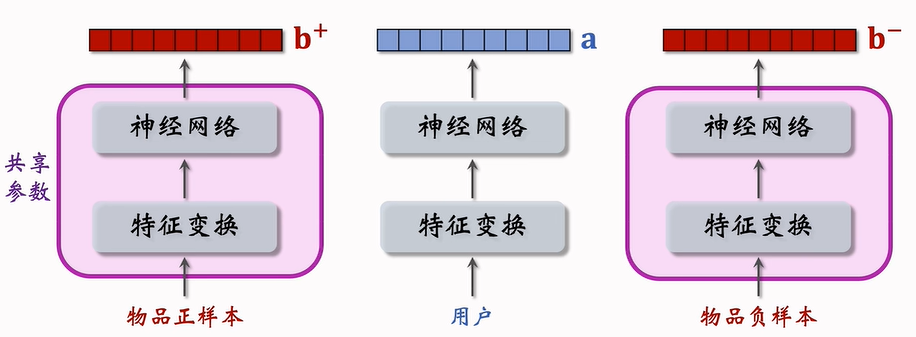
分别计算用户对两个物品的兴趣:
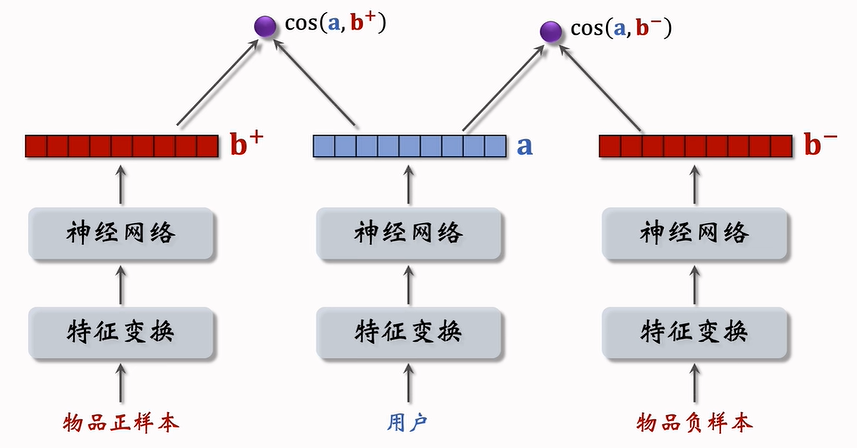
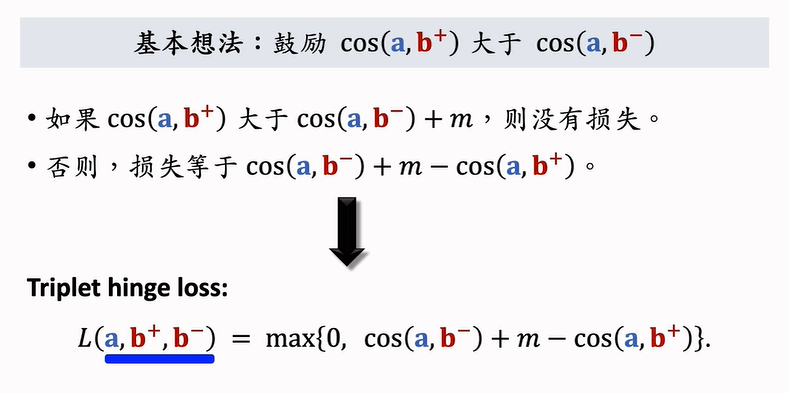
训练的时候每个训练样本都是个三元组,向量a是用户的表征,b+和b-分别是物品正负样本的表征。
我们希望损失函数越小越好,训练的过程就是对损失函数求最小化,用梯度更新双塔神经网络的参数。
Triplet hinge loss只是一种损失函数,Triplet logistic loss损失函数起到同样的作用。
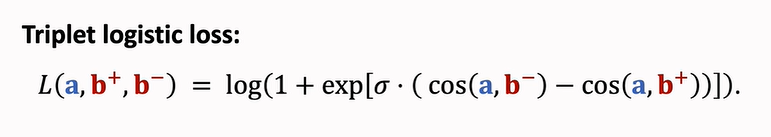
这里的σ是个大于0的超参数,控制损失函数的形状,σ需要手动设置
推导出Triplet hinge loss和Triplet logistic loss损失函数之后,可以通过最小化损失函数来训练双塔模型。训练样本都是三元组,其中一个用户,一个正样本物品,一个负样本物品。
Listwise训练
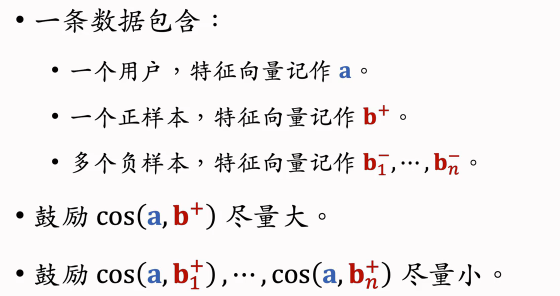
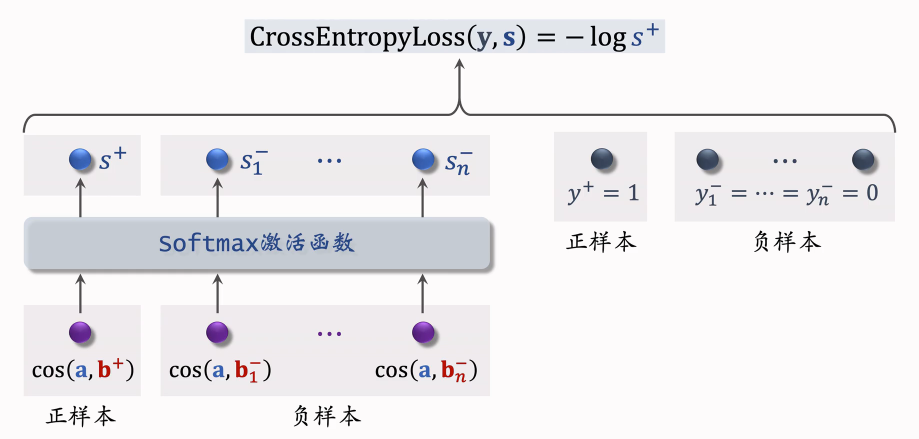
总结
双塔模型
不适用于召回的模型