推荐系统八股总结
精排
推荐算法的5个维度
交叉结构
FTRL:传统时代的记忆大师
FM
解决的问题:FM的前身就是LR,担心一阶特征表达能力弱,而加入了二阶特征交叉。
新的问题:引入二阶特征交叉后,增加了训练难度,具体体现在以下两点。
- 如果有n个特征需要两两交叉,增加的权重项
- 只有
基于以上问题,就提出了FM,公式如下:
创新点:
- 使得要学习的参数数量减少,由
- 还提升了扩展性,由于LR需要手动进行二阶特征交叉,没有出现过的特征组合无从学起,而FM虽然某种特征组合没有出现过,但是
其中,特征交叉部分可以优化为:
- 时间复杂度从
- 解决稀疏特征,
优化器可以使用FTRL算法。
Wide&Deep:兼顾记忆与扩展
Google 2016年发布的WIde&Deep。
该网络结构分为浅层网络Wide与深层网络Deep两部分组成,结构图如下:
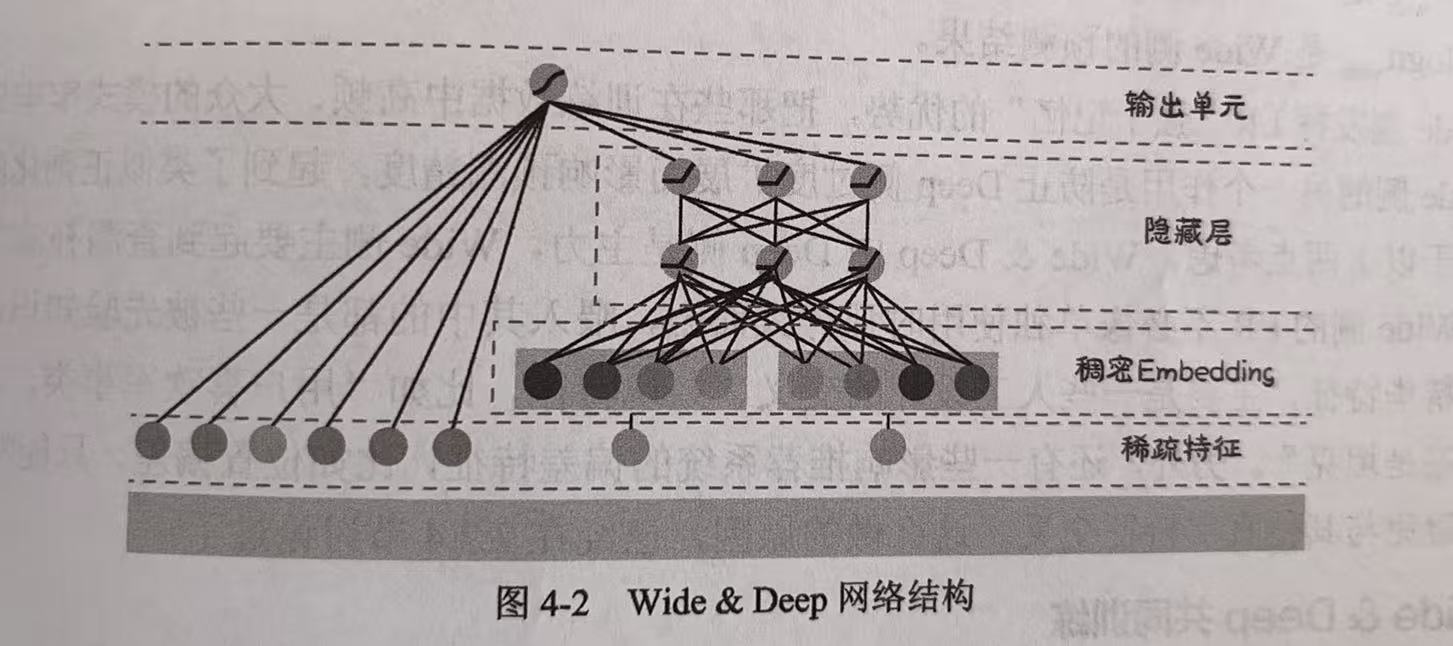
Deep侧是一个DNN:Embedding+MLP
- 对类别特征Embedding扩展了它们的内涵;
- DNN对特征进行高阶隐式交叉,增加了模型的扩展性和推荐的多样性。
Wide侧是一个LR
- 把在训练数据中出现过的高频、大众的模式记住;
- 防止Deep侧因过度扩展而影响预测精度,起到一个类似于正则化的作用。
Wide&Deep共同训练
- Wide侧使用FTRL优化器,为了保证稀疏性。
- Deep侧使用常规优化器,比如AdaGrad、Adam等。
DeepFM:融合二阶交叉
华为2017年发布DeepFM。
之前存在问题:Wide&Deep的Wide侧是一个LR,需要手动设计交叉特征,耗费尽力且严重依赖工程师的经验。
创新点:为了解决以上问题,在Wide侧增加了FM。
DeepFM原理公式如下:
讨论:
- 原论文中FM部分和DNN部分共享Embedding,缺点如下。所以具体实现时,可以让FM和DNN部分各自拥有独立的Embedding。
- FM要求所有特征Embedding的长度都必须相同;
- 不同模块共享Embedding可能会相互干扰。
- LR依旧发挥强于记忆的特点,同时防止Deep侧和FM侧过度扩展的正则化作用。其中
DCN:不在执着于DNN
之前存在问题:仅仅依靠DNN这种隐式交叉式远远不够的,该应该加上指定阶数的显示交叉作为补充。
为什么DNN产生的是隐式交叉?
答:由于由于DNN各层非线性激活函数的使用,DNN产生的交叉是无穷高阶的,无法明确用一个多项式表示。因此DNN产生的交叉为隐式交叉
DCNv1
DCNv2
DCNv1存在问题:参数容量有限,限制了模型的表达能力。(因为只有
DCNv2的改进点:
- 使用一个
- 但是矩阵给模型的计算和存储都带来了不小的压力,所以将权重矩阵分解为两个
缺点:
- 所有特征全部进行DCN交叉,参数量仍然不小,所以需要挑选一下重要特征进行交叉。
- 每个Cross Layer的输入输出都是d维,相当于只做信息交叉,而不做信息的压缩和提炼。
DCN和DNN融合
串联:
并联:
AutoInt:Transformer做交叉
用户行为序列建模
行为序列信息的构成
简单的Pooling
Sum Pooling
Average Pooling
Weighted-sum Pooling
DIN:用户建模要“千物千面”
解决的问题:
- 不同历史记忆对当下决策的影响程度并不相同
- 从用户行为序列中提取出的兴趣向量应该随当前候选物料的变化而变化,从而实现“千物千面”的效果
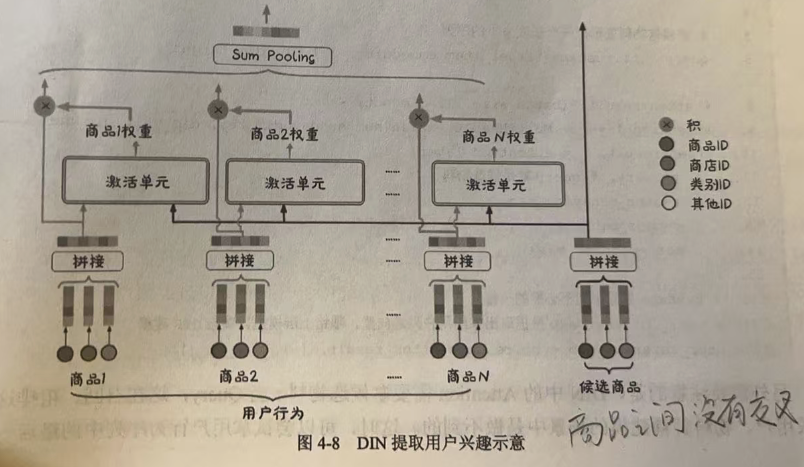
DIN核心思想可以参考公式如下:
- 其中,
需要注意的是,DIN中的Attention是那候选物料t当Query,但是在召回和粗排中,要求用户和物料解耦建模的场景中是做不到的,所以可以尝试使用用户行为序列中的最后一次物料当Query对整个物料进行Attention操作。
双层Attention:建模序列内的依赖关系
解决的问题:DIN只刻画了候选物料和行为序列元素的交叉,却忽略了行为序列内部各元素之间的依赖关系。
如何解决:采用双层Attention
多多益善:建模长序列
SIM:在线提取用户兴趣
解决的问题:
- Attention的时间复杂度太大,使得无法满足在线预测与训练更新的实时性要求。
- 而推荐系统有对用户长期行为序列建模的需求。如果建模的序列太短,可能会有用户的一些临时起意,算是一种噪声,无法学习到用户真正的兴趣。同时也无法反映用户一些周期性行为,比如每周或者每月的习惯性采购。
软过滤和硬过滤
DIN用候选物料t对行为序列
做Attention。和t相似的历史物料 的权重高,反之,权重低,这里Attention相当于对历史行为序列做软过滤。 在长序列中筛选出与候选物料t相关的短序列(称为Subuser Behavior Sequence 子用户行为序列),这个硬过滤的过程就是在做General Search Unit(GSU,通用搜索单元)。
使用硬过滤将历史行为序列从万级到百级,然后在SBS上使用DIN,这个过程就是Exact Search Unit(ESU,精确搜索单元)
硬过滤如何做?又分为硬搜索和软搜索。
硬搜索:使用候选物料t的某个属性,在用户完整的长期历史中搜索与其有相同属性的历史物料。
软搜索:使用候选物料的Item Embedding在历史行为序列中做ANN搜索算法,查找与之距离最近的前K个历史物料。
如何解决:先使用硬搜索得到SBS,然后在用SBS做DIN。
离线预训练用户兴趣
召回
传统召回
向量化召回统一建模框架
借助Word2Vec
阿里巴巴的EGES召回
阿里巴巴2018年提出的Enhanced Graph Embedding with Side Information(EGES)模型。
如何定义正样本
改进点:
-
Item2Vec 和 Airbnb I2I召回都认为只有同一用户在同一session内交互过得两个物料才有相似性。
-
EGES把这种跨用户、跨session的相似性考虑进去,这样能够提高模型的扩展性,也能够给那些冷门物料更多的训练机会。
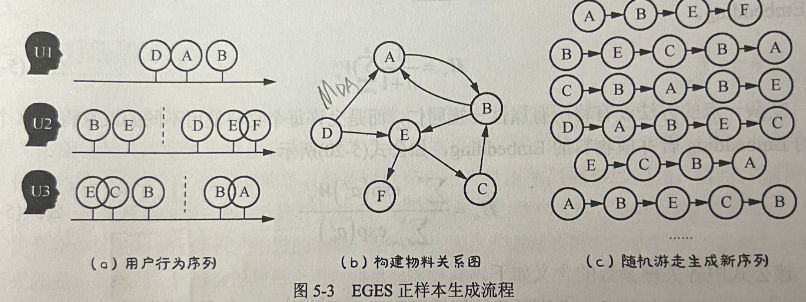
构建步骤:
- 先由图a构建到图b,图b边上的权重是
- 再由图b构建到图c,图b中由节点i走到节点j的概率为
- 然后再根据图c,套用word2vec,定义滑窗,滑窗内的两个物料是相似的,定义为正样本。
如何定义负样本
同Word2Vec的随机采样
如何构建Embedding
推荐系统与NLP的区别在于,NLP只有单词本身可以用于构建Embedding等,推荐系统除了物品ID,物料还有丰富的属性信息(side information)。
改进点:
- Item2Vec(照搬word2vec)没有用到物料的属性信息。
- EGES加入这些side information,有利于新物料的冷启动。
构建方法:
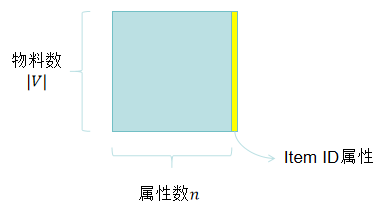
- 定义 n+1 个Embedding,每个Embedding矩阵
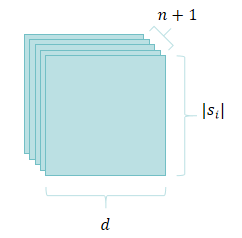
-
然后将物料ID Embedding和他的属性Embedding合并:
- 可以使用Average Pooling:
- 也可以使用权重矩阵

- 可以使用Average Pooling:
EGES与Airbnb的异同:
- 相同点:都引入了除了ID之外的其他属性信息(side information),弥补了word2vec用于推荐时无法处理新用户、新物料的不足,但是两者引入的方法又有不同。
- 不同点:
- Airbnb U2I使用人工先验规则进行分类,以学习某类用户,某类物品的Embedding代替学习单个用户或者物品的Embedding。这种方法引入属性信息的同时也使训练数据变得更加稠密,降低了训练难度。
- EGES引入了各类属性信息的Embedding,这些属性的Embedding是什么,以及这些Embedding如何进行融合,都需要算法自动学习。所以这种方法虽然避免了人工规则的繁琐和可能引入认为的偏见,但是也增加了模型的参数,是的模型需要更多的数据才能学习的更好。
如何定义损失函数
套用了word2vec的NEG Loss。
FM的召回功能
双塔模型
GCN召回
粗排与重排
多任务与多场景
多任务推荐
多任务建模的误区
为什么不为每个目标单独建模?
- 太浪费资源
- 用户转化是一个链条。
为什么不直接对终极目标建模?
并发建模
Shared Bottom
解决的问题(优点):实现了多任务之间的知识迁移
存在的问题:负迁移现象和跷跷板现象
MMoE
解决的问题:
- 解决了Shared Bottom存在的问题(负迁移和跷跷板现象)。
- 某个专家专注于某个任务的,从而每个任务都更新不同的参数,减少干扰。
如何解决?
- 不再用一套参数为所有任务共享;
- 也没有重走单独建模的老路;
- 专家依旧是所有任务所共享,但是共享程度由门控函数根据当前样本动态调整。
PLE(渐进式分层提取)
PLE模型结构如下图。
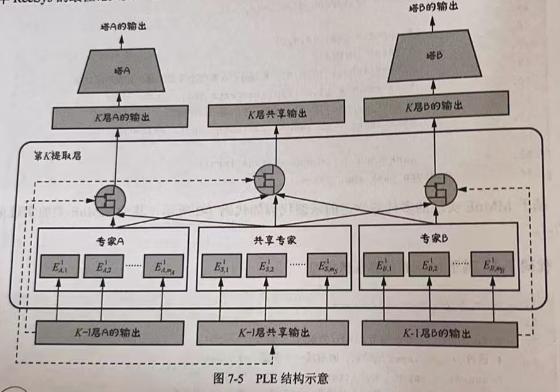
两点改进:
- 对模型共享部分继续拆解:将所有专家分为任务独占(task specific)和任务共享(task shared);
- MMoE中只具有一层专家,且专家之间的交互较弱。PLE引入多层专家,且专家之间层层递进、深化。